「schema.orgを入れれば、検索順位が上がる」。構造化データの話になると、まずこの期待が出てきます。SEOプラグインの機能一覧に「構造化データ対応」という項目が並んでいて、設定画面でチェックを入れるだけで済むように見えるため、順位を動かすスイッチのひとつだと受け取られるのも無理はありません。
しかし、これまで多くの記事の執筆からサイト側の出力設定まで一貫して手を入れてきた弊社の立場から言えるのは、schema.orgは順位を動かす設定ではなく、ページに書いてある事実を機械が誤読しない形で言い直す辞書だということ。書いていない事実は書けませんし、書けば規約違反になります。効き方はコードの巧拙ではなく、そのページの中身で決まるのです。
本記事では、schema.orgという言葉が指しているものから、JSON-LDでの書き方、公開後の検証手順、そして構造化データが効くページと効かないページの線引きまで、記事を作って入稿してきた側の視点で順に整理します。
- schema.orgと構造化データ、JSON-LDの3つが何をそれぞれ指しているのか
- JSON-LDで構造化データを書く5つの手順と、型の選び方
- マークアップが効きやすいページと、効きにくいページの見分け方
- 制作時に正しく書いた構造化データが半年後に壊れる原因と防ぎ方
- 公開前と公開後で使い分ける3つの検証ツールの役割
schema.orgとは検索エンジン共通の語彙集
schema.org(スキーマドットオルグ)とは、検索エンジンがWebページの内容を機械的に読み取るために使う「語彙」の仕様を定めた共同プロジェクト、およびその仕様を公開しているWebサイトを指します。会話のなかでは単に「スキーマ」と呼ばれることも多いため、社内で話が噛み合わないときは、サイトのことか語彙のことかを先に確かめると整理が早くなります。
語彙という言い方が抽象的に聞こえるかもしれませんので、中身を開いてみましょう。schema.orgが定めているのは、「これは記事である」「この項目は著者名である」と機械に伝えるための名前の一覧です。前者を型(Type)、後者をプロパティ(Property)と呼び、この2階層で世の中のモノと属性に名前が付けられています。記事ならArticle、企業ならOrganization、店舗ならLocalBusiness、商品ならProduct。それぞれの型に、著者を表すauthor、公開日を表すdatePublished、価格を表すpriceといったプロパティが用意されています。
型の総数は800を超えており、公式サイトで一覧を辿れます。ただし、この全部を覚える必要はありません。実務で使うのは、自社のページの主役に当たる数種類だけです。
schema.orgと構造化データの違い
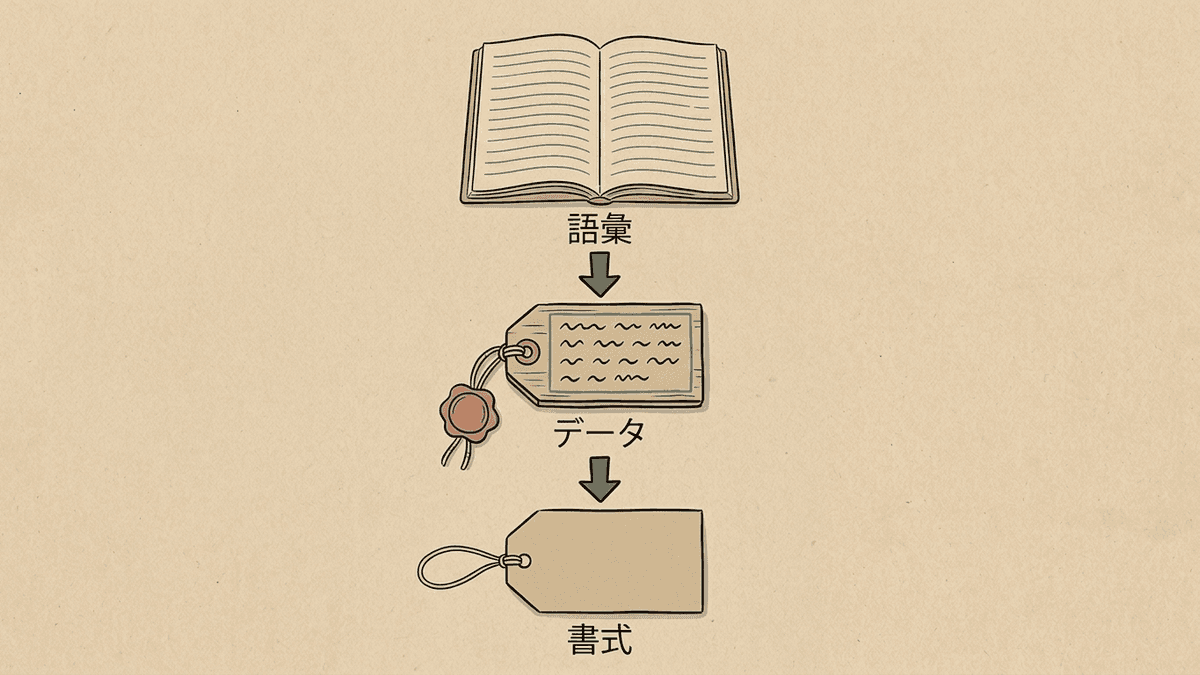
この2つは記事によって混ぜて使われがちですので、はじめに分けておきましょう。schema.orgが辞書や単語帳に当たるもので、構造化データはその単語を使って実際に書いた一文に当たります。そして、その一文をどの文法で書くかを決めるのがJSON-LDやMicrodataといった書式です。
- schema.org=何をどう呼ぶかの取り決め(語彙)
- 構造化データ=その取り決めに沿ってページに埋め込んだデータそのもの
- JSON-LD/Microdata/RDFa=そのデータを書くための書式
分けておくと得をする場面があります。たとえば「schema.orgに対応していますか」と聞かれたとき、語彙として正しく書けているという意味なのか、Googleが検索結果の見え方を変えてくれる型で書けているという意味なのかで、答えがまるで変わってきます。schema.orgの語彙として正しくても、Googleが検索機能として扱っていない型なら、検索結果の見た目は一切変わりません。この食い違いが、後述する検証ツールの使い分けにそのままつながります。
2011年に主要検索エンジンが共同で立ち上げた経緯
schema.orgは2011年6月、GoogleとBing、Yahoo!が共同で発表しました。のちにYandexも運営に加わっています。
では、なぜ検索エンジン同士が手を組む必要があったのか。それ以前は、Microformatsやdata-vocabulary.orgなど複数の語彙が並び立っていて、サイト側は「どの語彙で書けばどのエンジンに伝わるのか」を自力で判断しなければならなかったのです。共通の語彙を1つ用意すれば、サイト側は一度書くだけで主要エンジンに同じ意味が届く。この分業の整理が、当時の発表の狙いでした。
なお、Googleは古い語彙であるdata-vocabulary.orgのサポートを2020年に終了しています。10年以上前に構築したサイトを引き継いだ場合、この古い記述が残っているケースがありますので、既存サイトに手を入れるときは書式ごと確認したほうが安全です。
※ 発表当時の経緯はGoogle検索セントラルのブログ記事に、現在サポートされている語彙と形式は検索セントラルの構造化データの解説に記載されています。

関連記事:【2025年最新版】初心者でもできるSEOのやり方完全ガイド | 上位表示するための具体的な方法を徹底解説
schema.orgでできること3つ
語彙の話が続きましたので、ここから実利の話に移ります。構造化データを書いて得られることは、大きく3つに整理できます。
検索結果の見え方が変わる
もっとも目に見える変化がこれです。パンくずリストがURLの代わりに表示される、レビューの星が並ぶ、商品の価格と在庫状況が出る、求人の勤務地や給与が出る、イベントの開催日が一覧になる。こうした通常の青リンクとは違う表示を、Googleはリッチリザルトと呼んでいます。
ただし、マークアップすれば必ず表示されるという保証はありません。Googleが表示するのは、公式の検索ギャラリーに掲載されている機能に限られ、そのうえで表示するかどうかはGoogle側の判断になります。書いたのに出ないという相談をよく受けますが、多くは「その型がGoogleの検索機能に含まれていない」か「必須プロパティが欠けている」のどちらかです。
ページの内容を取り違えられにくくなる
見た目が変わらない場面でも、意味はあります。ページの中に日付が2つ並んでいるとき、どちらが公開日でどちらが更新日なのかは、本文のレイアウトだけでは判断がつきません。datePublishedとdateModifiedで明示しておけば、この取り違えは起きにくくなります。
同名の企業や人物の区別も同じ理屈です。sameAsというプロパティで公式SNSアカウントや公的な登録情報を指しておけば、別の同名企業と混ざるリスクを下げられるでしょう。検索結果の見え方に直結しないため後回しにされがちですが、社名や店舗名が一般的な単語に近い企業では、先に手を付ける価値があると見ています。
AI検索や音声アシスタントに拾われやすくなる
AI Overviewや生成AIの回答にページが引用されるとき、どの記述がどの事実に当たるのかが機械可読になっていれば、扱いやすい情報であることは確かでしょう。著者が誰で、いつの情報で、何の価格なのかが構造として取れるかどうかは、文章から推測させるよりは確実です。
ただし、構造化データを入れたからAIに引用されるという因果は、どの検索エンジンも公表していません。ここは期待値を高く置かず、「引用されるうえで不利にはならない整備」として扱うのが妥当だと考えています。
 経営者
構造化データを入れた記事だけ、順位が上がったりするものでしょうか。
 Writers-hub
編集部
順位そのものが上がるという話は、Googleからは出ていません。ただ、検索結果でパンくずや公開日が表示されて占める面積が広がれば、同じ順位でもクリックされる機会は増えます。順位を動かす施策ではなく、同じ順位での見え方を整える施策として考えていただくと、判断を間違いにくくなります。
関連記事:.htaccessとは?できることと書き方や置き場所を解説
構造化データの3つの書き方と選び方
構造化データを書く書式は3つあります。結論から申し上げると、新しく実装するならJSON-LDを選んでください。理由は表のあとに説明します。
| JSON-LD | Microdata | RDFa | |
|---|---|---|---|
| 書き方 | scriptタグ内にJSON形式で一括記述 | HTMLタグにitemprop属性などを追記 | HTMLタグにproperty属性などを追記 |
| 本文HTMLとの関係 | 分離している | 一体化している | 一体化している |
| Googleの推奨 | ◎ | ○ | ○ |
| テンプレート化のしやすさ | ◎ | △ | △ |
| 本文の構造変更への強さ | ◎ | × | × |
JSON-LD
scriptタグの中にJSON形式でまとめて書く方式です。本文のHTMLから独立しているため、デザインを変えても構造化データが壊れません。CMSのテンプレート側で出力を組み立てやすく、Googleも推奨しています。
Microdata
HTMLタグにitemscope、itemtype、itempropといった属性を足していく方式です。既存のHTMLに追記する形で始められるため、小規模な追加なら選ぶ理由もあるでしょう。一方、本文のマークアップと一体になっているため、デザイン変更でタグの入れ子が変わると属性の対応も崩れます。制作会社が交代したあとに壊れやすいのは、この方式で書かれたページです。
RDFa
HTMLの属性でvocabやtypeofを指定する方式で、Linked Dataの文脈で使われてきました。日本のWeb制作で新規採用される例はほとんど見かけません。既存サイトで採用されている場合を除き、選択肢から外して構わないでしょう。
関連記事:noindexとは?書き方と設定方法・効かないときの原因を解説
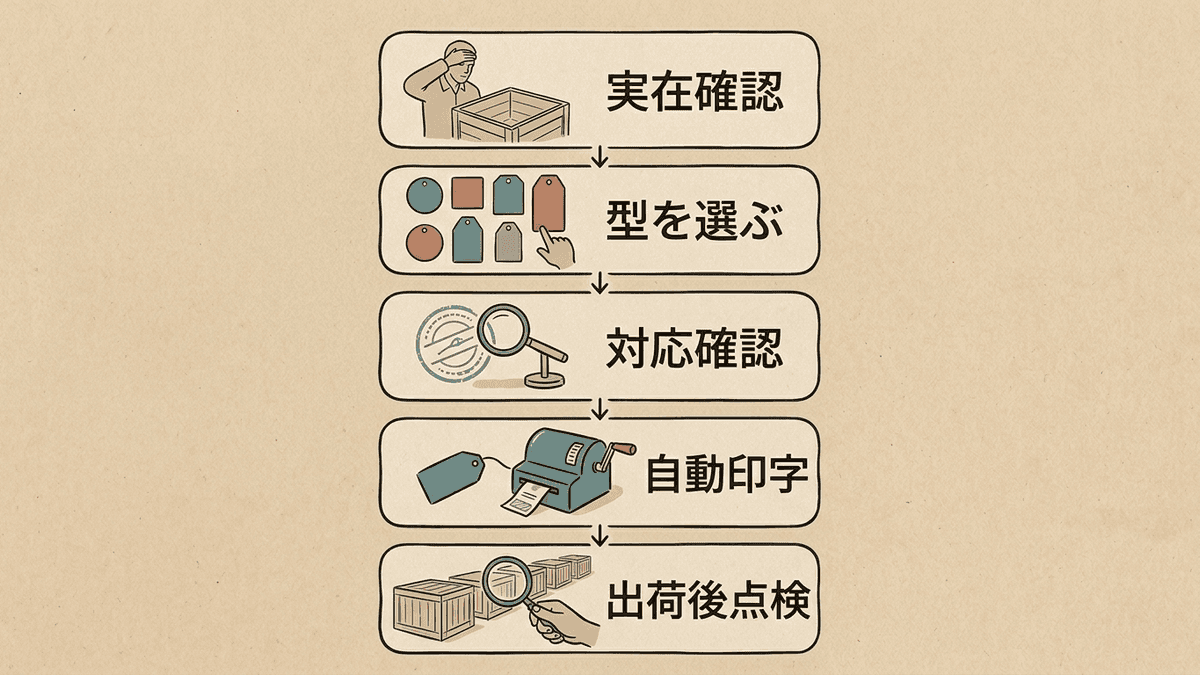
JSON-LDで実際に書く5ステップ
書式が決まったら、実装の手順に入ります。難所は3つ目です。
記事ならArticleかBlogPosting、企業紹介ならOrganization、実店舗のページならLocalBusiness、商品詳細ならProduct。1ページにつき主役は1つに絞ります。
schema.org側の型の定義と、Googleの検索ギャラリーに載っている機能ごとの必須項目は別物です。検索結果の見え方を変えたいなら、後者の必須項目を基準にしてください。
ここが実装の分かれ目です。値は本文に表示されている内容と一致させてください。表示していない情報を値に入れるのはガイドライン違反です。
type属性にapplication/ld+jsonを指定します。head内でもbody内でも読み取られますので、テンプレートの都合で決めて構いません。
リッチリザルトテストとSchema Markup Validatorの両方に通します。役割が違うため、片方だけでは見落とします。
3つ目の「本文に書いてある事実だけ」という制約が、実装の難易度をほとんど決めています。記事のJSON-LDを例に、最小限の形を見てみましょう。
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "記事のタイトル",
  "datePublished": "2026-09-13T10:00:00+09:00",
  "dateModified": "2026-09-20T15:00:00+09:00",
  "author": {
    "@type": "Person",
    "name": "著者名"
  },
  "publisher": {
    "@type": "Organization",
    "name": "運営会社名"
  }
}
冒頭の@contextでschema.orgの語彙を使うことを宣言し、@typeで型を指定します。authorやpublisherのように、値がさらに別の型になる入れ子はよくある形です。この短い記述でも、著者名と公開日がページに表示されていなければ違反になるという点は変わりません。
schema.orgが効くページと効かないページ
ここが本記事のいちばんの要点です。
構造化データの解説は書き方の説明に紙面を割きがちですが、実務で成果の差を生むのは書き方ではありません。マークアップできるのは、ページに書いてある事実だけです。この一点が、効くページと効かないページを分けています。
裏を返せば、検索結果やAIの回答に出したい事実がそのページに書かれていないなら、先にやるべきはコードの追加ではなく本文の加筆です。順番を逆にすると、書く材料がないままJSON-LDのテンプレートだけが増え、必須プロパティが空のまま放置されることになります。
- 住所や電話番号、営業時間が本文に載っている店舗ページ
- 商品名と価格、在庫状況が表示されている商品詳細ページ
- 著者名と公開日を明記している記事ページ
- 勤務地や雇用形態、給与を書いている採用ページ
- 開催日と会場、参加方法を載せているイベントページ
並べてみると共通点が見えてきます。どれも「検索する人が知りたい具体的な事実が、ページの表面に出ている」ページです。逆のパターンも挙げておきましょう。
- 価格も実績も載せていないサービス紹介ページ
- 著者名も日付も出していない考え方だけのコラム
- 質問と回答を並べただけのFAQページ
- 手順を解説したページ
後ろの2つには補足が必要でしょう。FAQのリッチリザルトは、2023年に表示対象が政府機関や医療機関などの一部サイトに絞られました。手順を解説するHowToのリッチリザルトも、同じ時期に廃止されています。どちらも数年前の解説記事では「やっておくべき施策」として紹介されていました。古い記事を参考に実装計画を立てると、表示されない前提のものに工数を割くことになります。
※ どの機能がいま表示の対象になっているかは、Googleの検索ギャラリーの記載が基準になります。対象と必須項目は更新されるため、実装前にその型のページを開いて確認してください。
つまり、構造化データを検討するときの最初の問いは「どの型を入れるか」ではありません。「このページには機械に渡す事実が書かれているか」であり、次に「その型はいま実際に表示されるのか」です。この順番で見ていくと、手を付けるページと後回しにするページが自然に分かれます。
マークアップする前に、そのページに出す事実が揃っているか確かめたいとき
自社のどのページに事実が書かれていて、どのページは本文の加筆が先なのか。この切り分けは、サイト全体を見渡さないと判断がつきません。弊社では検索結果とAI検索の両方を前提に、書くべき内容と整備すべき出力を合わせて設計しています。
本文と構造化データがずれる運用上の落とし穴
制作時には正しく書けていたのに、半年後に見たら壊れていた。この相談が、実装そのものの相談より多いのが実情です。
原因はコードの書き間違いではありません。本文と構造化データが別々に更新される運用になっていることです。本文はCMSの編集画面から誰でも直せるのに、JSON-LDはHTMLに手書きされていて、編集担当者が触れる場所にない。この状態を放置すると、更新のたびに両者が離れていきます。
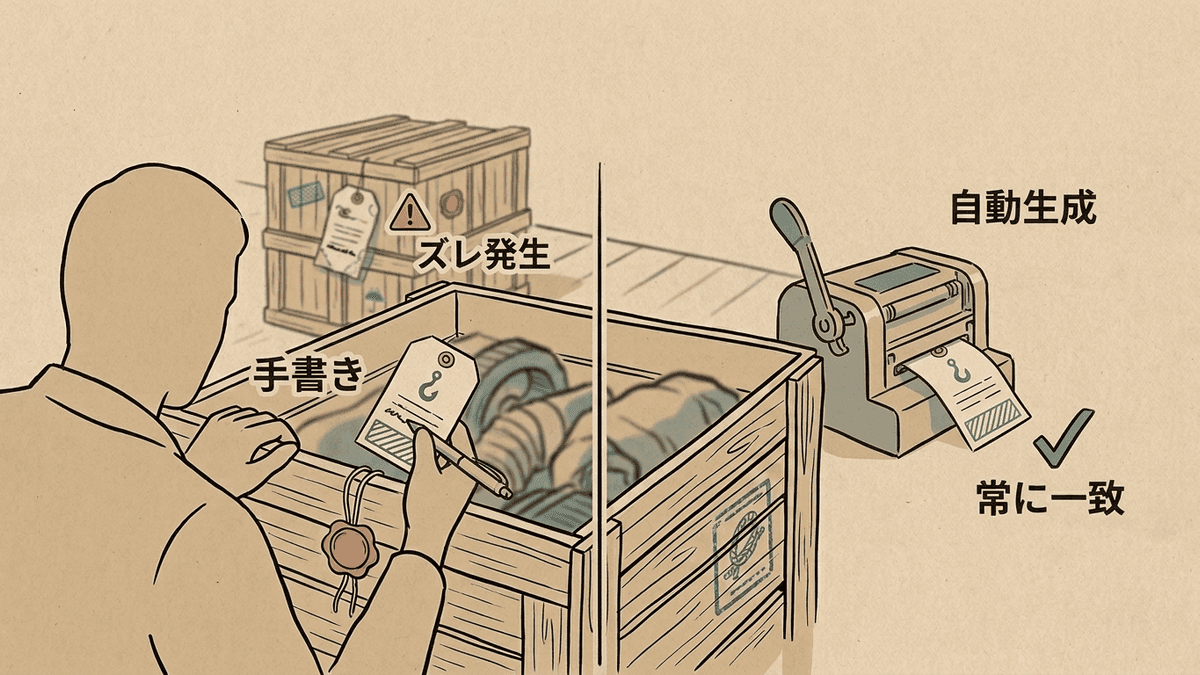
実際に見かける壊れ方を挙げます。記事をリライトして公開日を新しくしたのに、JSON-LDのdatePublishedが古いまま残っている。著者を交代したのにauthorが前任者の名前になっている。商品の価格を改定したのに、Productのpriceが旧価格を指している。別ページのJSON-LDをコピーして流用し、headlineだけ直してurlを直し忘れる。どれも、悪意ではなく手順の欠落から起きます。
Googleは、構造化データの内容がページに表示されている内容と一致していることを求めています。価格や在庫のように取引に関わる項目のずれは、単なる不整合ではなく、ガイドライン違反として扱われる領域です。
古い価格や在庫状況を指したままにしておくと、表示対象から外されるだけでなく、手動による対策の対象にもなります。商品ページを持っているサイトは、価格改定の手順に構造化データの確認を組み込んでください。
では、どう防ぐか。現場で機能している答えは1つです。JSON-LDは手書きせず、本文の項目から自動で生成する。CMSのテンプレート側で、タイトル、公開日、著者、価格といったフィールドを参照して出力する形にしておけば、編集担当者が本文を直した時点で構造化データも追従します。手で書くのは、テンプレートに乗らない例外ページだけに限る。この線引きを最初に決めておくかどうかで、1年後の状態がはっきり分かれます。
あわせて、公開後の見回り当番も決めておきましょう。Search Consoleの拡張レポートを月に1回開いて、エラー件数が増えていないかを見る。それだけでも、壊れたまま半年放置される事態は避けられるはずです。
ここまでをまとめると、構造化データの品質は実装時の正確さより、更新のたびに本文と揃い続ける仕組みがあるかどうかで決まります。実装を外注する場合も、納品物として求めるのはJSON-LDそのものではなく、本文から生成する仕組みのほうです。
本文の更新に構造化データが追いつかない状態を、体制ごと直したいとき
構造化データのずれは、書き方の知識ではなく、誰がいつ何を確認するかという編集体制の問題として現れます。弊社は記事の企画から執筆、入稿、公開後の確認までを一続きの工程として引き受けており、出力の整備もその工程に含めて設計します。
書いた構造化データを検証する手順
検証ツールは3つあり、それぞれ見ているものが違います。ここを混同すると「エラーが出ていないのに表示されない」という行き詰まりに入ります。
- リッチリザルトテスト=Googleの検索機能として認識されるかを見る(Googleが対応する型のみ)
- Schema Markup Validator=schema.orgの語彙として正しいかを見る(Googleが未対応の型も確認できる)
- Search Consoleの拡張レポート=公開後にサイト全体で何件エラーが出ているかを見る
使う順番は決まっています。公開前は前の2つを両方通してください。リッチリザルトテストだけだと、Googleが機能として扱っていない型は「検出されませんでした」と返るだけで、語彙として正しいかどうかは分かりません。逆にSchema Markup Validatorだけだと、語彙としては正しいのに検索結果の見え方が変わらない理由に気付けません。
公開後はSearch Consoleに移ります。1ページずつテストするのは現実的ではありませんので、サイト全体のエラー件数と対象ページの推移を見る運用に切り替えます。数十ページ規模なら月1回、商品ページが数千ある規模なら週1回が目安になるでしょう。
導入前に知っておきたい注意点
最後に、避けたい進め方を挙げておきます。
- ページに表示していない情報をマークアップする
- 自社で用意したレビューや評価を書き足す
- 有利になると考えて関係のない型を並べる
- 構造化データだけ整えて、本文の内容不足を放置する
いちばん多いのは4つ目です。構造化データは検索エンジンに向けた説明書きであって、読む人に向けた中身ではありません。中身が足りないページに説明書きを付けても、読んだ人の評価は変わらないのです。
よくある質問
相談を受けるなかで繰り返し出てくる質問を、短い答えから順にまとめます。
直接上がるとは言えません。Googleは構造化データを順位付けの要因として公表していません。ただし、パンくずや公開日が検索結果に表示されて占める面積が広がれば、同じ順位でもクリックされる機会は増えます。
スキーマドットオルグと読みます。会話では省略して「スキーマ」と呼ばれることが多いため、話し相手がサイトのことを指しているのか語彙のことを指しているのかは、確認したほうが行き違いを防げます。
どちらでも読み取られます。テンプレートの都合で決めて構いません。ただし、JavaScriptで後から挿入する方式にすると読み取りが不安定になる場合がありますので、サーバー側で出力する形を優先してください。
記事やパンくずのような基本の型は任せて構いません。ただし、出力された値が本文と一致しているかは公開後に一度確認してください。著者名や公開日をプラグインの既定値のまま出しているサイトを、たびたび見かけます。
有利にはなりません。ページの主役に当たる型を1つ選び、必要に応じて補助の型を足す形にしてください。関係のない型を並べると、どれが主役なのか読み取れなくなります。
schema.orgの公式サイトは英語で提供されています。日本語で読める資料としては、Googleの検索セントラルにある構造化データの解説が仕様の要点を押さえており、実装時の参照先としては十分です。
まとめ|順位を上げる施策ではなく事実の言い直し
schema.orgは検索エンジンが共通で使う語彙集で、構造化データはその語彙で書いたデータ、JSON-LDはその書式です。この3つを分けて捉えると、社内の会話も外注先への依頼もぶれにくくなります。
実装で押さえる点は2つに絞れます。1つは、マークアップできるのはページに書いてある事実だけだということ。事実が書かれていないページでは、コードを足す前に本文の加筆が先に来ます。もう1つは、手書きせずCMSのテンプレートから生成しておくこと。本文の更新に構造化データが自動で追従する形にしておけば、半年後に価格や著者名がずれている事態を避けられます。
私たち合同会社Writers-hubは、記事の企画から執筆、入稿、公開後の数値確認までを一続きの工程として引き受けています。構造化データの整備も、コードを書く作業として切り出すのではなく、「そのページに何を書くか」と同じ工程のなかで設計してきました。順位表示だけでなくAI検索での扱われ方まで含めて検索経由の接点を増やしたい場合は、どのページから手を付けるかの整理からご一緒できます。
どのページから構造化データを整えるか、順番の相談から始めたいとき
本文の加筆が先なのか、出力の整備が先なのか。この判断はサイトの規模と既存ページの状態で変わります。現状をお聞きしたうえで、着手する順番からお話しします。