「noindexを付ければ、そのページは検索結果から消える」。重複した一覧ページや公開をやめたキャンペーンページの扱いで、この前提のままご相談をいただくことがあります。WordPressでもCMSの管理画面でも、noindexはチェックボックス1つで切り替わる作りのため、押せば終わる作業だと受け取られやすいのでしょう。ところが数日たっても、そのページは検索結果に出たままです。
しかし、企業サイトの記事を作り、公開後のインデックス状況まで追いかけてきた弊社の立場から言えるのは、noindexは検索から隠す設定ではなく、読ませたうえで載せないよう頼む指定だということです。クローラーがページを取得し、head内のタグを読んで初めて効くため、クロールを止めていればいつまでも効きません。robots.txtで同じページを塞いだまま反映を待っている、というのが、消えないというご相談で最も多い形です。内容が重なっているだけのページなら、canonicalで正規のURLを示すほうが向きます。
本記事では、noindexの意味と3つの書き方から、設定すべきページの選び方、効かないときの原因の切り分けまで、記事を作ってきた側の視点でお伝えします。
- noindexの役割と、nofollowやrobots.txtとの違い
- metaタグ・HTTPレスポンスヘッダー・WordPressの3つの書き方
- 設定すべきページと、付けなくてよいページの線引き
- 検索結果から消えないときの確認の順番
- 記事に付ける前に検討したい選択肢
noindexとは検索結果に載せない指定
noindex(ノーインデックス)とは、そのページを検索エンジンのインデックスに登録しないよう伝える指定です。インデックスとは検索エンジンが持つ索引で、ここに登録されたページだけが検索結果に並びます。書き方は主に2つ、head内に置くrobots metaタグと、サーバーが返すHTTPレスポンスヘッダーに含めるX-Robots-Tagです。
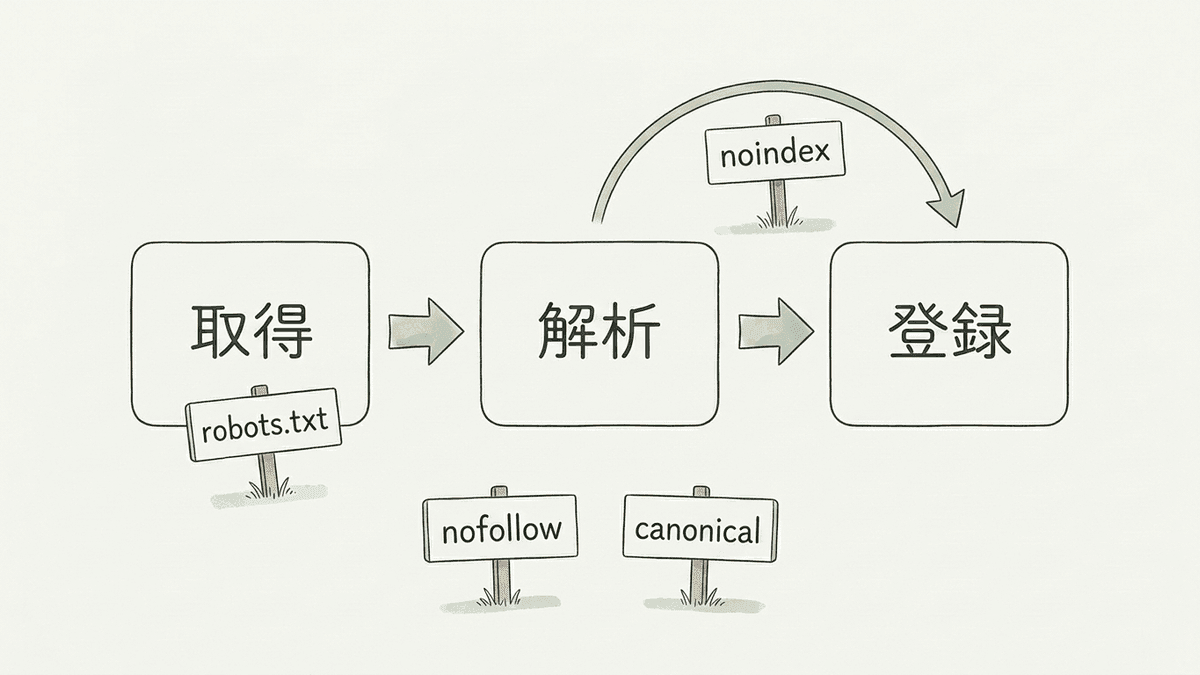
押さえておきたいのは働く順番です。検索エンジンはページを取得し、中身を解析し、索引に載せるかを判断します。noindexが読まれるのは2番目の解析の段階です。ページが取得されなければ何も伝わりません。
公式ドキュメントにも、noindexが効くにはページがrobots.txtでブロックされていない必要があると明記されています。
nofollowやrobots.txtとの違い
検索結果に出したくないという目的に使われる指定はほかにもあり、名前が似ていて混ざりやすいので先に整理します。
指定 | 伝えている内容 | 検索結果への表示 |
|---|---|---|
noindex | 索引に載せないでほしい | 消える |
nofollow | リンク先を評価に含めないでほしい | 変わらない |
robots.txt | この範囲をクロールしないでほしい | 消えないことがある |
canonical | 内容が同じページの正規URLはこちら | 正規URL側が残る |
nofollowはリンクに対する指定で、ページを索引から外す働きはありません。とりわけ誤解が多いのはrobots.txtです。クロールを止める指定であって索引から外す指定ではないため、外部からリンクされているページはURLだけが検索結果に残ることがあります。なおrobots.txtに直接noindexと書く方法は、Googleが2019年にサポートを終了しました。
canonicalが伝えるのは「こちらにまとめてほしい」であり、noindexの「載せないでほしい」とは向きが違います。選び方はcanonicalタグとは何かで整理しています。
関連記事:【2025年最新版】初心者でもできるSEOのやり方完全ガイド | 上位表示するための具体的な方法を徹底解説
noindexを設定する3つの方法
HTMLを直接編集できるか、サーバーを触れるか、CMSを使っているかで選ぶ道が変わります。
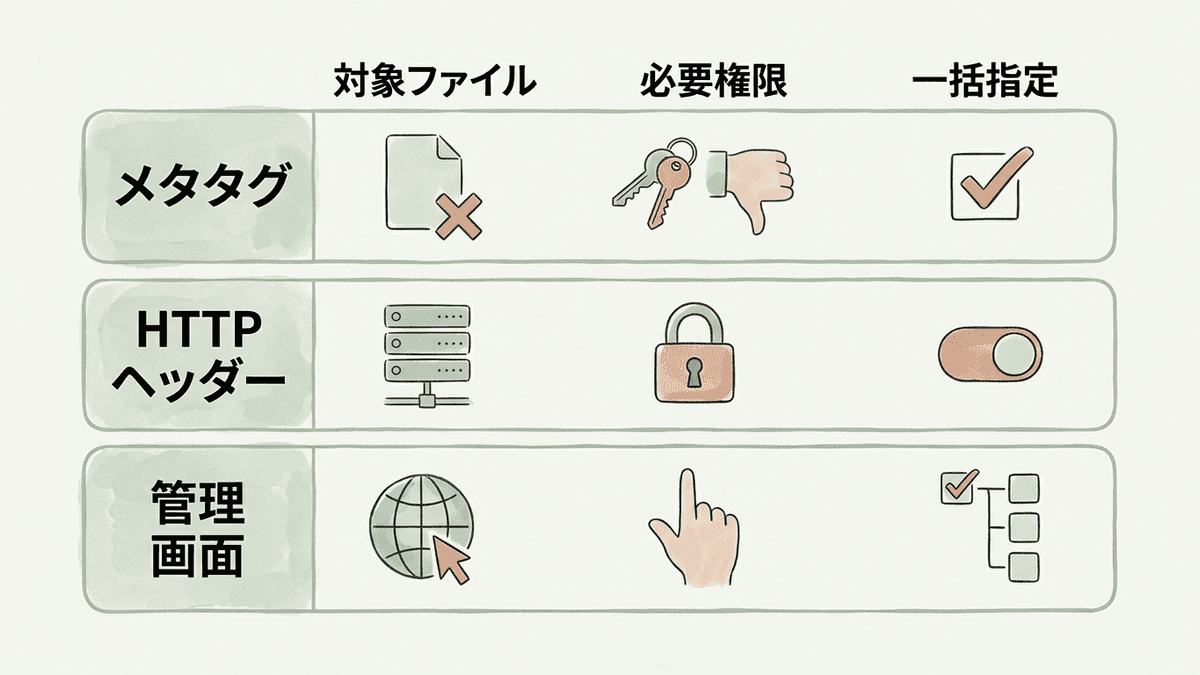
metaタグに記述する書き方
最も一般的なのが、head内にrobots metaタグを書く方法です。すべての検索エンジンに伝えるならnameにrobotsを指定します。
<head>
  <meta name="robots" content="noindex">
</head>
リンクもたどってほしくない場合は、値をカンマで並べてnoindex, nofollowとします。注意したいのは書く場所です。metaタグはheadの中に書かないと読まれません。body内では無視されます。JavaScriptで後から差し込む形も読まれない場合があるため、サーバーが返すHTMLに含めるほうが確実でしょう。
HTTPレスポンスヘッダーでの指定
PDFや画像のようにHTMLではないファイルには、metaタグを書く場所がありません。この場合はHTTPレスポンスヘッダーにX-Robots-Tagを含めます。
# Apache(.htaccess)でPDFファイルすべてに指定する例
<FilesMatch "\.pdf$">
  Header set X-Robots-Tag "noindex"
</FilesMatch>
拡張子やディレクトリを条件にまとめて指定できるため、対象が多いときに向きます。Nginxならlocationディレクティブでadd_headerを使います。想定より広い範囲に効くこともあるので、反映後は対象外のヘッダーも確認してください。
資料ダウンロード用のPDFにはこの指定が要ります。PDFもHTMLと同じようにインデックスされるため、ダウンロードページを作り込んでいても中身が直接検索結果に出ることがあります。
WordPressの管理画面での設定
WordPressなら、サーバーやテーマのファイルを触らずに指定できます。サイト全体への指定は、管理画面の「設定」から「表示設定」を開き、「検索エンジンがサイトをインデックスしないようにする」にチェックを入れる形です。制作中のサイトを出さないための機能で、公開後に外し忘れると全ページが検索結果から消えてしまいます。公開手順書に「チェックを外す」の1行を入れておきましょう。
個別の投稿や固定ページには、Yoast SEOやAll in One SEO、SEO SIMPLE PACKといったプラグインの設定欄を使います。入れ替えると前の指定が外れることがあるため、移行時は対象ページを一覧にすると取りこぼしません。
関連記事:dofollowとは?nofollowとの違いと設定不要な理由を解説
noindexを設定すべきページの例
どのページに付けるかは、検索から来た人がそこで目的を果たせるかで判断します。
- 問い合わせ完了や資料請求完了を知らせるサンクスページ
- ログイン後にだけ意味を持つマイページ
- 条件の組み合わせで増えるサイト内検索の結果ページ
- 終了したキャンペーンや、掲載を終えた求人ページ
- 確認用に一時公開しているテスト環境のページ
サンクスページは分かりやすい例でしょう。検索から直接たどり着いた人には、申し込んでいないのに完了画面が出るだけです。計測の起点に使っているなら、検索経由の到達が混ざって数字の意味も変わります。一方、次のページは対象から外して考えてください。
- 順位が上がらないだけの記事(低さは外す理由になりません)
- 内容が重なっている記事同士(統合かcanonicalが向きます)
- 一時的に非公開にしたいページ(下書きに戻すほうが確実)
- カテゴリーやタグの一覧ページ(使われているなら残す)
判断が分かれるのは最後の一覧ページです。中身が1〜2件しかない一覧が大量にあるなら外す判断も働きますが、そこから次の記事が選ばれている一覧まで一律に外す必要はありません。遷移が起きているかをアクセス解析で確かめてから決めてください。
どのページを検索に出すかの線引きが、担当者ごとに違っていませんか
1ページずつ考えると、noindexにするかどうかの答えは人によって変わります。弊社では検索対策の設計とあわせて、どのページに人を集め、どこを受け皿に回すのかの整理から承っています。
関連記事:.htaccessのリダイレクト|ケース別の書き方と効かない原因
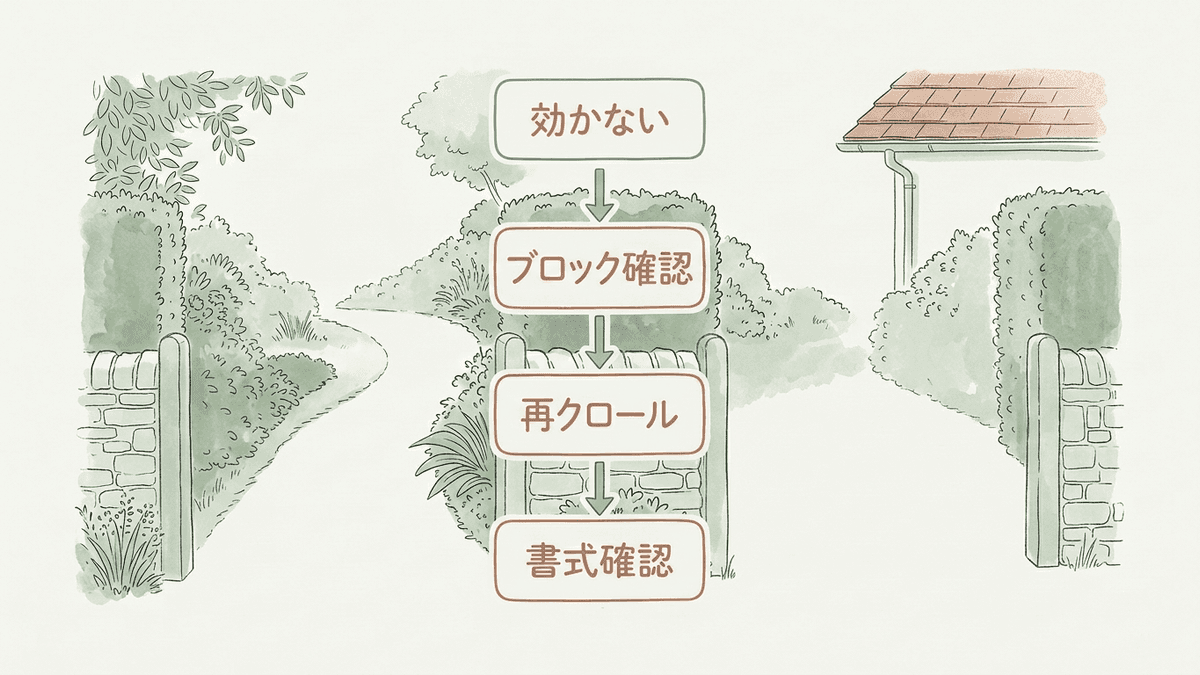
noindexが効かない3つの原因
設定したのに検索結果から消えない。この相談は繰り返し寄せられます。原因はおおむね3つで、上から順に確認すると早く済みます。
robots.txtでクロールを止めている
最も多いのがこれです。早く消したい一心で、noindexと同時にrobots.txtでも同じURLを塞いでしまう。するとクローラーはそのページを取得できません。
robots.txtで塞いだページのnoindexは読まれない。両方を設定したほうが確実だという発想が裏目に出る理由です。しかも外部からリンクされていれば、URLとリンク文言だけで検索結果に並ぶことがあります。
対処は、該当するDisallowを外してクローラーが取得できる状態に戻し、noindexが読まれるのを待つことです。索引から外れたのを確認してからrobots.txtを戻す分には問題ありません。
noindexとrobots.txtのDisallowを同じURLに同時指定しない。クロールを止める指定と、読ませて判断させる指定は両立しません。
再クロールがまだ来ていない
塞いでいないのに消えない場合、次に疑うのは時間です。noindexは設定した瞬間ではなく、そのページが次にクロールされたときに初めて読まれます。更新頻度の低いページほど間隔が開きます。
急ぐならSearch ConsoleのURL検査ツールから登録をリクエストしてください。索引に載せる依頼と受け取られそうですが、送っているのは再取得の依頼です。noindexが書かれていれば読み取られて索引から外れます。
※ 反映までの期間はサイトの規模や更新頻度で変わります。更新の多いサイトの主要ページで数日、止まっている下層ページでは数週間かかることもあるというのが、公開後の状況を追ってきた範囲での目安です。
 経営者
急いで消したいページがあります。リクエストは何度も送ったほうが早く反映されますか。
 Writers-hub
編集部
何度送っても速度は変わりません。それより確認したいのは、そのページに内部リンクが張られているかです。どこからもリンクされていないページは優先度が下がりやすいので、一時的にサイトマップへ載せるほうが早く来ます。
記述の場所や書式の誤り
3つ目は記述そのものです。ソースコードを開き、metaタグがhead内にあるかを確かめてください。テーマやプラグインの出力位置によっては、意図せずbody側に入っていることがあります。双方が出力して二重になり指定が食い違うときは、制限の強いほう、つまりnoindexが採用されます。
見落としがちなのがCMSやCDNのキャッシュです。編集画面では設定を変えたのに、配信されるHTMLは変更前のまま、という状態が起こります。設定を変えたらキャッシュを削除し、配信されているHTMLを確認してください。
noindexの確認と解除の手順
設定できているかは、思い込みではなく画面で確かめます。道は3つあります。
ページ上で右クリックしてソースを表示し、コードの中でrobotsを検索します。1ページを急いで確かめるなら最も速い方法です。
検索窓へURLを入力すると、索引に登録されているか、除外の理由は何かが表示されます。最終クロール日も分かります。
noindexで除外されたページを一覧で確認できます。意図せず付いたページが増えていないかは、この画面で見ます。
3つ目の一覧は月に一度は開きたい画面です。テーマの更新やプラグインの入れ替えをきっかけに、公開中の記事へnoindexが付く事故は実際に起こります。原因を状態別に切り分ける手順はGoogleにインデックスされない原因にまとめました。
解除は、記述を消すか値をindexに書き換えるかです。直したらURL検査から再取得をリクエストします。ここでも即座には戻らず、再クロールを待つ形になります。
noindexで隠せない範囲
ここからは、解説記事ではあまり触れられない部分です。noindexを「そのページを見せなくする設定」だと受け取っていると扱いを誤ります。
noindexは非公開にする手段にはならない。伝えているのは検索結果に載せないでほしいということだけで、ページ自体は誰でも開けます。URLを知る人には見えるため、社外に出せない資料や公開前の告知ページには、ベーシック認証やログインの必須化といったアクセス制限が要ります。
noindexを付けたページには後始末が残ります。XMLサイトマップから外し、そのページへの内部リンクとナビゲーションの導線を見直してください。外すページをサイトマップに載せたままだと指示が食い違います。
記事にnoindexを付ける前の3つの道
低品質な記事にはnoindexを、という説明をよく見かけます。ここは記事を作る側として踏み込んでお伝えします。
noindexは棚上げであって記事の改善ではない。索引から外れれば検索結果には出なくなりますが、内容も費やした時間もそのまま残ります。順位が上がらない記事に取れる道は4つあり、noindexはその1つにすぎません。
| 記事を書き直す | 似た記事を統合する | 記事を削除する | noindexを付ける | |
|---|---|---|---|---|
| 検索からの流入 | 増やせる | 統合先に集まる | 失う | 失う |
| かかる手間 | 大きい | 中程度 | 小さい | 小さい |
| 内部リンク | そのまま使える | 統合先へ転送 | 転送先の指定が要る | 残る |
| 元に戻せるか | 戻せる | 戻しにくい | 戻せない | 戻せる |
| 向く場面 | 検索する人がいる | 同じテーマが複数 | 事実として古い | 検索に出す前提なし |
表を縦に見ると、noindexが向くのは最下段の「検索に出す前提がない」場合だけだと分かります。求人の終了ページやサンクスページはこれに当たります。逆に、検索する人がいるテーマなのに順位が上がっていないだけの記事は書き直しの対象です。索引から外しても検索する人は消えず、その需要は競合が受け取ります。判定の基準は低品質コンテンツの判定基準とnoindexの判断フローで扱っています。
 Web担当者
古い記事が数十本あります。全部書き直す時間はないので、まとめてnoindexにするのは避けたほうがよいですか。
Writers-hub編集部
まとめて、という進め方は避けてください。まず検索されているテーマかどうかで2つに分けます。検索されていないほうはnoindexか削除で構いません。残したほうは順位が近いもの同士を統合すると、書き直す本数が減ります。
仕分けは社内でも進みますが、書き直す手が空かないまま止まる例をよく見かけます。棚上げした1年のあいだに検索結果が競合で埋まる形は避けたいところです。
書き直したほうがよい記事だと分かっていて、手が回っていませんか
弊社では既存記事を、書き直す記事、統合する記事、外してよい記事に仕分けし、手を入れる分の制作まで承っています。何本あるか分からない段階で構いません。
noindexについてよくある質問
設定や運用の場面でいただく質問をまとめました。
対象のページを正しく選んでいれば影響はありません。ただし公開したい記事にまで広く付ければ、その分の流入は失われます。
クロールは止まりません。noindexが読まれるにはページの取得が必要だからです。
robots.txtでそのURLのクロールを止めている可能性が高い状態です。中身を取得できないため、外部リンクを手がかりにURLだけが残ります。
まとめ|noindexは隠す設定ではない
noindexは、そのページを検索エンジンの索引に載せないよう伝える指定です。書き方はhead内のrobots metaタグ、HTTPレスポンスヘッダーのX-Robots-Tag、CMSの管理画面の3つです。
付けたのに消えないときは、robots.txtでクロールを止めていないか、再クロールが来ているか、記述の場所と書式が正しいかの順に確認してください。記事については、書き直しと統合を先に検討することをおすすめします。検索する人がいるテーマなら、索引から外しても需要は消えません。
私たち合同会社Writers-hubは、企業サイトの記事を制作し、公開後のインデックス状況や順位の動きまで見ながら運用を支援しています。設定の当たり外れより、どのページを検索に出し、どのページを外すのかを先に決めるほうが、手戻りは少なくなるはずです。
noindexで棚上げしたページが、どれだけあるか把握できていますか
検索に出すページと出さないページの線引きが担当者ごとに違う、過去に付けたnoindexの一覧が残っていない。その段階でしたら現状の確認から一緒に整理します。