「クローラーは検索エンジンのロボットのことで、サイト側は来てもらうのを待つだけでよい」。SEOの入門記事ではGooglebotを例にクローラーが説明されることが多いため、クローラーと聞いて検索エンジンだけを思い浮かべる方は多いでしょう。
しかし、これまで多くのサイトで記事の制作から公開後の検索対策まで携わってきた弊社の立場から言えるのは、今のサイトに来るクローラーは、送り主も目的もばらばらだということです。サーバーのアクセスログを開くと、検索エンジンのほかに、生成AIの企業やSEOツールのクローラーの名前が並んでいることも珍しくありません。
本記事では、Webクローラーの意味と巡回の仕組みから、種類ごとの受け入れ方、自分でクローラーを使って情報を集めるときの注意点まで、サイト運用を支援する制作会社の視点で順を追ってお伝えします。
- Webクローラーは、リンクをたどってWebページを自動で取得し、保存するプログラム
- クローラーは送り主で検索エンジン・AI・SEOツール・データ収集の4種類に分かれ、受け入れ方も種類ごとに違う
- robots.txtはクローラーごとに許可と拒否を書き分けられるが、ページを検索結果から隠す仕組みではない
- OpenAIの検索用クローラーまで拒否すると、ChatGPTの検索回答に自社のページが出なくなる
- 自分でクローラーを使うときは、利用規約・robots.txt・アクセスの間隔を先に確かめる
Webクローラーとは?検索エンジンとの関係
Webクローラーとは、Web上のページを自動で訪れ、内容を取得して保存するプログラムのことです。ページ内のリンクを次々にたどって巡回する動きから、スパイダーやボットとも呼ばれます。
検索結果の材料は、クローラーが集めたページです。Googleの場合、Googlebotがページを取得し(クロール)、内容を分析してデータベースに登録し(インデックス)、検索された語に合うページを順に並べます。クローラーに取得されていないページは、検索結果に出る候補にも入りません。
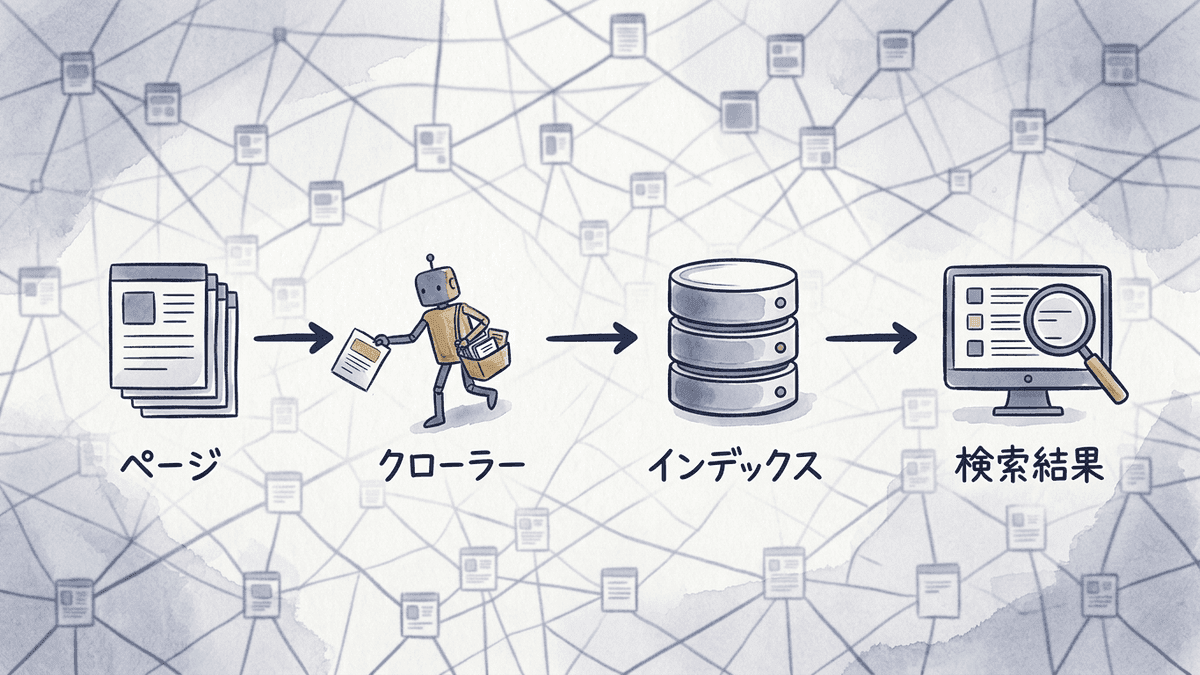
一方で、取得されたページがすべて検索結果に出るわけではありません。Search Consoleで「クロール済み - インデックス未登録」と表示されるページのように、取得された後に登録を見送られることもあります。Googlebotに巡回を申請する方法と、登録されないときに見る場所は、Googleクローラーの解説記事にまとめました。
Webクローラーがページを巡回する仕組み
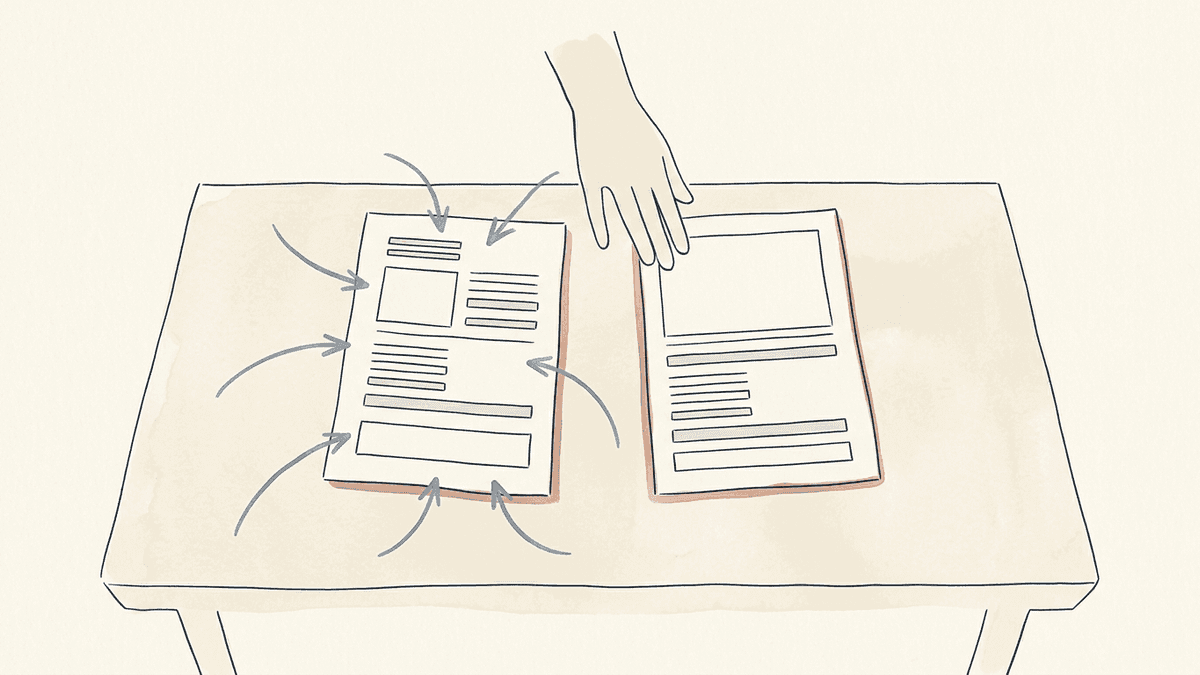
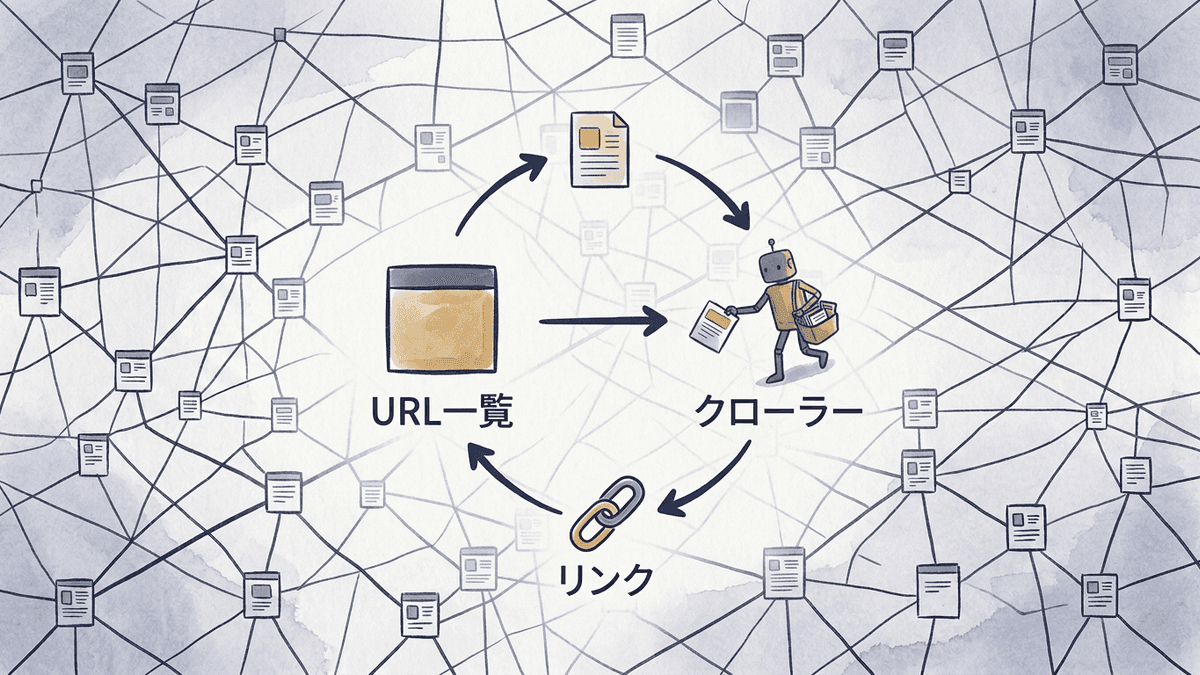
Webクローラーは、すでに知っているURLから出発し、ページの中のリンクをたどって新しいURLを見つけていきます。1回の巡回は、次の4つの工程のくり返しです。
一覧には、過去に見つけたURLや、サイト運営者がXMLサイトマップで伝えたURLが入っています。
ルールを守るクローラーは、サイトの直下に置かれたrobots.txtを読み、自分が拒否されているURLを取得しません。
検索エンジンのクローラーはページ全体を、データ収集用のクローラーは決めた項目だけを保存します。
取得したページで見つけたリンクのURLを、次に巡回する一覧に加えます。
クローラーは見つけたリンクからしか新しいURLを知らないため、どこからもリンクされていないページはクローラーに見つかりにくいのです。公開した記事に内部リンクが1本もなく、サイトマップにも載っていなければ、クローラーはそのURLを知る手段がありません。
見落とされがちなのが、JavaScriptで後から表示するリンクです。GooglebotはJavaScriptを実行してページを表示しますが、すべてのクローラーがJavaScriptを実行するわけではありません。巡回してほしいページへのリンクは、HTMLのaタグとして最初から書いておくと、JavaScriptを実行しないクローラーにも見つけてもらえます。
Webクローラーの種類と送り主
Webクローラーは、送り主と目的で大きく4種類に分かれます。サイト運営者が受け入れるかどうかの判断も、種類ごとに変わります。
| 主なクローラー | 集める目的 | サイト側の基本の扱い | |
|---|---|---|---|
| 検索エンジン | Googlebot、Bingbot | 検索結果に載せるページを集める | 受け入れる |
| AI企業 | GPTBot、OAI-SearchBot | AIの学習やAIの検索回答に使う | 学習用と検索用を分けて決める |
| SEOツール | AhrefsBot、SemrushBot | 被リンクや順位の分析データを集める | サーバーの負荷が問題になれば制限する |
| データ収集 | 企業や個人が作ったクローラー | 価格や求人などの情報を集める | 利用規約とrobots.txtで取得の条件を示す |
表の中で扱いを誤りやすいのが、AI企業のクローラーです。同じ会社のクローラーでも、学習用と検索用で名前が分かれていることがあります。Googleは、検索用のGooglebotとは別に、生成AIの学習などに使うかを指定するための「Google-Extended」という名前を用意しています。
Google-Extendedはサイトを巡回するクローラーではなく、robots.txtに書くための名前です。Googleは、Google-Extendedを拒否してもGoogle検索への登録や順位には影響しないと説明しています。
※ 出典:Google「Google の一般的なクローラー」
robots.txtによるクローラーごとの制御
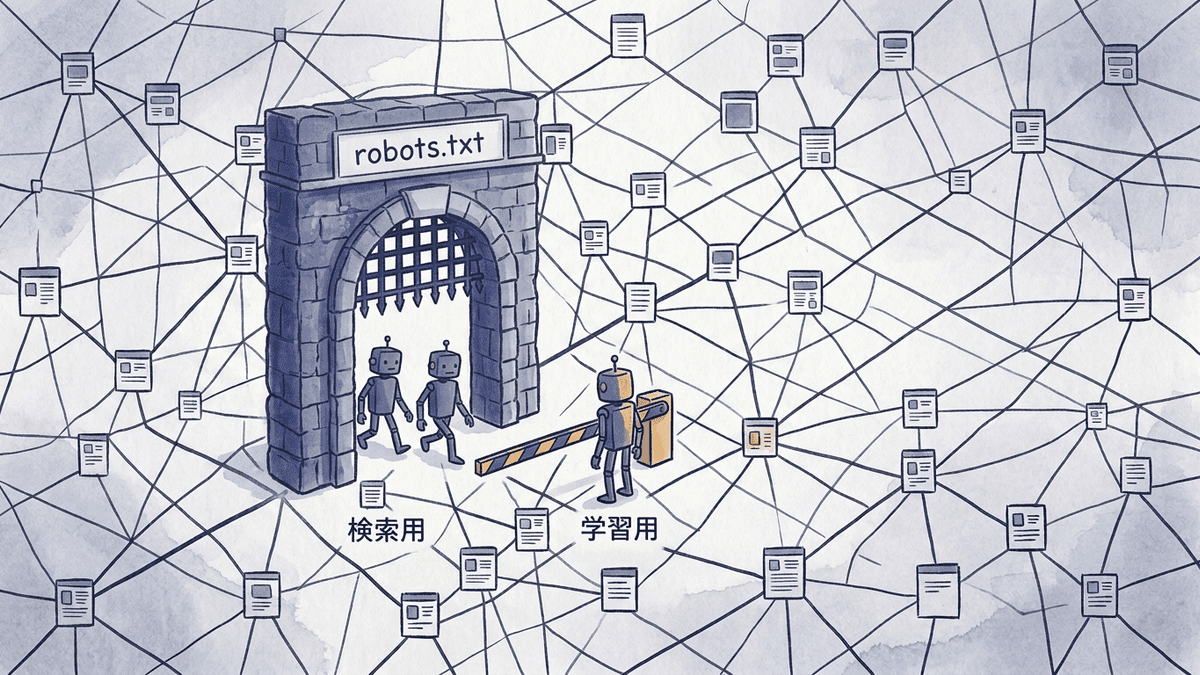
robots.txtは、サイトの直下に置くテキストファイルで、どのクローラーにどのURLの取得を許可するかを書きます。User-agentの行にクローラーの名前を、Disallowの行に拒否するURLを書きます。
User-agent: GPTBot
Disallow: /

User-agent: *
Disallow: /admin/
記載例のrobots.txtは、OpenAIの学習用クローラーであるGPTBotにはサイト全体の取得を断り、ほかのクローラーには管理画面の「/admin/」だけを断る書き方です。名前を指定したグループがあるクローラーは、自分の名前のグループのルールだけに従い、「*」のルールは読みません。
robots.txtでページは隠せない
robots.txtで拒否したURLでも、ほかのサイトからリンクされていれば、Googleの検索結果に表示されることがあります。拒否されたURLが検索結果に出るときは、ページの説明文が表示されません。
検索結果から外したいページには、robots.txtではなくnoindexを使います。noindexはクローラーがページを取得して初めて読めるため、同じURLをrobots.txtで拒否すると効きません。書き方はnoindexの解説記事で紹介しました。
robots.txtに従うかどうかは、クローラーの作り手しだいです。Googleは、Googlebotなどの一般的なクローラーは自動クロールでrobots.txtのルールに従うと説明していますが、名前を名乗らないボットはrobots.txtを読まずにページを取得することがあります。名前を名乗らないボットを止めるには、サーバーやCDNの設定でアクセス元を遮断します。
※ 出典:Google 検索セントラル「robots.txt の概要とガイド」
AIクローラーは学習用と検索用で分けて判断
OpenAIは、クローラーを目的別に分けて公開しています。GPTBotは生成AIの基盤モデルの学習に使うページを集め、OAI-SearchBotはChatGPTの検索機能で表示するサイトを集めます。
※ 出典:OpenAI「Overview of OpenAI Crawlers」
OpenAIの説明では、OAI-SearchBotを拒否したサイトは、案内のリンクとして表示されることはあっても、ChatGPTの検索回答には表示されません。また、ユーザーの操作をきっかけにページを読みに行くChatGPT-Userには、robots.txtのルールが適用されない場合があるとも説明しています。
 Web担当者
自社の記事をAIに学習されたくないので、AI関連のクローラーはrobots.txtでまとめて拒否しようと考えています。何か困ることはありますか。
 Writers-hub
編集部
学習を断るかどうかは、サイト運営者が決めてよいことです。ただ、AIの会社のクローラーを名前でまとめて拒否すると、ChatGPTの検索回答に出るためのOAI-SearchBotまで止めてしまいます。学習用のGPTBotと検索用のOAI-SearchBotを分けて書き、検索回答から訪問してもらう道を残すかどうかは別に決めてください。
学習用の名前だけを拒否し、検索用のクローラーは許可する。Googleに対しても同じ書き分けができ、Googlebotを許可したままGoogle-Extendedだけを拒否すれば、Google検索への掲載を保ったまま、Geminiの今後のモデルの学習への利用を断れます。
AIに学習はさせず、AIの検索回答には出したいと考えていませんか
どのAIクローラーを許可するかは、AI検索からの訪問をどれだけ重視するかで決まります。Writers-hubのSEO・AI検索対策では、アクセスログに来ているクローラーの確認から、robots.txtの書き分け、AIの回答に引用される記事づくりまでをご相談いただけます。
クローリングとスクレイピングの違い
クローリングはリンクをたどってページを集めること、スクレイピングは取得したページから必要なデータだけを抜き出すことです。
項目 | クローリング | スクレイピング |
|---|---|---|
行うこと | リンクをたどってページを集める | ページから決めた項目を抜き出す |
できあがるもの | ページの一覧と内容 | 価格や日付などを並べた表のデータ |
主な使い手 | 検索エンジン、AI企業 | 価格調査、求人や不動産の情報収集 |
クローリングは集める工程、スクレイピングは抜き出す工程と分けると、2つの語の関係を取り違えません。実際の情報収集では、1つのプログラムがページを集めてから項目を抜き出すため、Webクローラーの名前で提供されているツールにも、スクレイピングの機能を持つものが一般的です。
Webクローラーで情報を集めるときの注意点
Webクローラーで他社のサイトから公開情報を集めることは、それだけで違法になるわけではありません。ただし、相手のサイトのルールとサーバーの負担を守らないと、アクセスの遮断や法的な問題につながります。取りかかる前に、次の5点を確かめてください。
- 対象のサイトに、APIやデータ提供の仕組みがないか
- 利用規約で、プログラムによる自動取得が禁止されていないか
- robots.txtで、取得したいURLが拒否されていないか
- アクセスの間隔を空け、同時に多数のリクエストを送らない設定になっているか
- 集めるデータに、個人情報や、転載すると著作権の問題になる文章・画像が含まれていないか
とりわけ見落とされがちなのが、アクセスの間隔を決めるのは相手のサーバーの能力だという点です。2010年には、岡崎市立中央図書館の蔵書検索サイトに、新着図書の情報を集めるプログラムで1秒に1回程度アクセスしていた利用者が、偽計業務妨害の疑いで逮捕されました。利用者はのちに起訴猶予となり、図書館は閲覧障害の原因が図書館のシステム側にあったと認めています。
自分に悪意がなくても、相手のサーバーが止まれば問題になります。取得を始めた後は、相手のサイトからエラーが返ってきたら間隔を広げるか止まるように、プログラムを設定しておきます。Googleの検索結果そのものを集めたいときの規約と代わりの取得方法は、Google検索結果のスクレイピングの解説記事にまとめました。
ツール・自作・代行の選び分け
Webクローラーを用意する方法は、ノーコードのツール、自作、収集代行サービスの3つです。どれを選ぶかは、対象サイトのページの作りが変わったときに、誰が設定を直すかで決まります。
| 始めるまでの手間 | 対象サイトが変わったとき | 向いている場面 | |
|---|---|---|---|
| ノーコードのツール | 画面で取得する項目を選ぶ | 自分で設定をやり直す | 数サイトから同じ項目を定期的に集める |
| 自作(Scrapyなど) | プログラミングが必要 | 自分でコードを直す | 収集の条件が細かい、件数が多い |
| 収集代行サービス | 要件を伝えて見積もりを取る | 契約の範囲で代行会社が直す | 社内に保守する人がいない |
自社サイトのリンク切れやタイトルの抜けを調べたいだけなら、SEO用のクローラーツールで足ります。Screaming FrogのSEO Spiderは、無料版でも1回の巡回で500URLまで調べられます。
競合の価格や新着情報を、毎週手作業で集めていませんか
手作業の情報収集を自動化するときは、対象サイトの規約とrobots.txtの確認、取得の間隔、サイトの作りが変わったときの直し方を先に決めておく必要があります。Writers-hubの業務効率化・自動化では、集めたい情報と対象サイトを伺ったうえで、自動化の方法を一緒に決めていきます。
Webクローラーのよくある質問
Webクローラーについて、サイト運営の相談でよく受ける質問と答えをまとめました。
サーバーのアクセスログで確認できます。ログのユーザーエージェントの欄に、GooglebotやGPTBotなどクローラーの名前が記録されます。Googlebotの訪問回数やエラーは、Search Consoleの「設定」にある「クロールの統計情報」でも確かめられます。
本物とは限りません。ユーザーエージェントの名前は、誰でも名乗れるためです。Googleは、アクセス元のIPアドレスを逆引きしてgooglebot.com、google.com、googleusercontent.comのいずれかになるかを確かめる方法と、Googleが公開しているIPアドレスの一覧と照らし合わせる方法を案内しています。
Googleは、Googlebotが平均して数秒に1回を超える頻度でサイトにアクセスすることはないと説明しています。訪問の間隔は、サイトの更新の頻度や、サーバーが速く応答できるかどうかでも変わります。
公開ページを自作のクローラーで集めること自体は、それだけで違法にはなりません。ただし、利用規約に反する取得や、相手のサーバーに障害を起こす頻度のアクセス、集めた文章や画像の転載は、契約違反や業務妨害、著作権侵害を問われるおそれがあります。
まとめ|Webクローラーは送り主と目的で扱いを分ける
Webクローラーは、リンクをたどってページを自動で集めるプログラムで、検索エンジン、AI企業、SEOツール、データ収集と、送り主によって目的が違います。サイトを運営する側もクローラーを使う側も、相手が誰で何のために取得するのかを確かめてから扱いを決めます。
- 公開したページに内部リンクを張り、XMLサイトマップに載せる
- robots.txtは、クローラーの名前ごとに許可と拒否を書き分ける
- 検索結果から外すページには、robots.txtでなくnoindexを使う
- AIのクローラーは、学習用と検索用を分けて判断する
- 自分で集めるときは、規約・robots.txt・アクセスの間隔を先に確かめる
私たち合同会社Writers-hubは、記事の制作から公開後の検索対策まで、検索エンジンにもAIの検索にも正しく読まれるサイトづくりを支援しています。
自社サイトに来ているクローラーを、一度整理してみませんか
robots.txtに何を書くか、どのクローラーを受け入れるかは、検索とAI検索のどちらからの訪問を重視するかで変わります。検索対策とAI検索対策のどちらから手を付けるか決めきれていない段階でも、今のサイトの状況を伺ったうえでご相談に応じます。