「ページ数が多いのにインデックスされないのは、クロールバジェットが足りないからだろう」。Googleのヘルプでも「検出 - インデックス未登録」はサイトの過負荷を避けてクロールを先送りした状態と説明されているため、割り当てを増やせば解決すると思われがちです。ところが、Googleの解説では、クロールの頻度を上げるよう頼むことはできず、サイト側で最も確実に管理できるのは、Googleが見つけたURLのうちどれをクロールさせるかだと説明されています。数千〜数万ページのサイトで先に見直したいのは、割り当ての量より、テンプレートが自動で作る不要なURLの数です。
本記事では、クロールバジェットの意味と気にすべきサイトの目安から、不要なURLを減らす3つの手順まで、Googleの公式ドキュメントに沿ってお伝えします。
- クロールバジェットは、Googleが1つのホスト名のクロールに割り当てる時間とリソースを指す
- Googleは、100万ページ以上で週1回、1万ページ以上で毎日更新されるサイトなどを管理の対象にしている
- 数千〜数万ページのサイトでは、ページ数より、テンプレートが生むURLの数を先に確かめる
- 不要なURLは、URLと内部リンク、テンプレートの出力、サイトマップの順に減らす
- noindexではクロールは減らず、クロールを止めたいURLにはrobots.txt、削除したページには404か410を使う
クロールバジェットとは
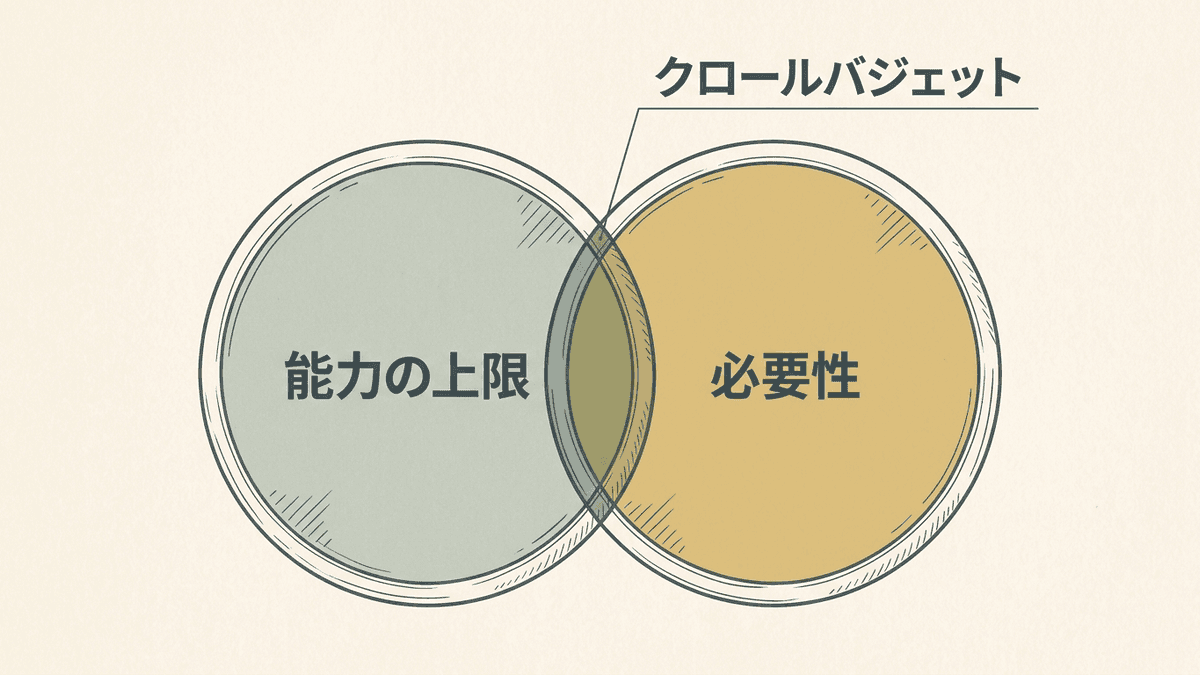
クロールバジェットとは、Googleが1つのサイトのクロールに割り当てる時間とリソースのことです。公開されているURLをすべて調べることはGoogleの能力を超えるため、サイトごとに上限が設けられています。
ここでいうサイトはホスト名の単位で、サブドメインごとに別のクロールバジェットが割り当てられます。Googleの例では、https://www.example.com/ と https://code.example.com/ は別々のサイトです。
クロールバジェットの大きさは、次の2つの要素で決まります。
要素 | 中身 | 上がる・下がる条件 |
|---|---|---|
クロール能力の上限 | サーバーに負担をかけずにGoogleが使える接続の数と時間 | 応答が速く安定していれば上がり、応答の遅れ、5xxエラー、429が返ると下がる |
クロールの必要性 | Googleがそのサイトをクロールしたい度合い | サイトの規模、更新の頻度、ページの品質、関連性、URLの人気で変わる |
サーバーに余裕があっても、クロールの必要性が低ければクロールは減ります。
クロールされたページが、すべてインデックスに登録されるわけではありません。Googleはクロールした後にページを評価し、インデックスに載せるかを判断します。Googlebotがページを見つけてから検索結果に出すまでの流れは、Googleクローラーとは?巡回申請の方法と来ないときの原因を解説で取り上げています。
クロールバジェットを気にすべきサイトの目安
クロールバジェットの管理が必要なサイトとしてGoogleが挙げるのは、主に次の3種類です。
- 重複のないページが100万以上あり、内容が週1回ほど更新されるサイト
- 重複のないページが1万以上あり、内容が毎日更新されるサイト
- Search ConsoleでURLの大部分が「検出 - インデックス未登録」になっているサイト
Googleは、ページ数の値は大まかな目安で、正確なしきい値ではないとしています。
頻繁に更新するページが多くないサイトや、公開したページがその日のうちにクロールされているサイトは、Googleの管理ガイドを読む必要はありません。Google検索については、サイトマップを最新の状態に保ち、ページのインデックス登録レポートを定期的に見るだけで十分とされています。
数千ページのサイトは、ページ数の2つの目安のどちらにも入りません。数万ページのサイトも、内容を毎日更新するのでなければ入らないでしょう。一方で「検出 - インデックス未登録」の条件は、ページ数を問いません。Googleは指示が無ければ、見つけたURLのすべてかほとんどをクロールしようとするため、作ったページが少なくても、見つかるURLが多ければ当てはまることがあります。
データベース型サイトでURLが増える原因
データベース型サイトで、作ったページよりURLが増えるのは、1つのテンプレートが絞り込みや並べ替えの組み合わせごとに別のURLを出力するからです。Googleは、絞り込みのURLは役に立たないと分かるまで大量にクロールされ、不要なURLに時間を取られるぶん新しいURLの発見が遅れると説明しています。
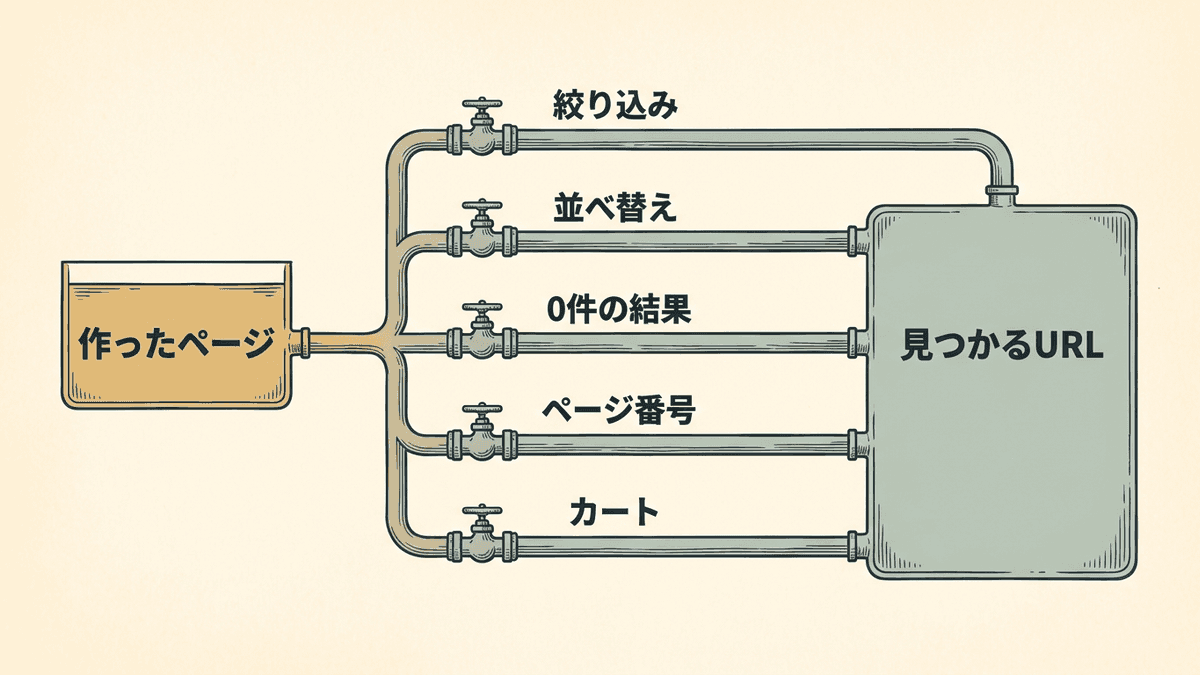
Googleの案内をもとにすると、テンプレートが自動で作り、クロールの無駄になりやすいURLは次の5つです。
- 絞り込みの組み合わせごとのURL
- 並べ替えやセッションIDのパラメータが付いたURL
- 結果が0件なのに200を返す検索・絞り込みのページ
- 存在しないページ番号のURL
- カートや会員登録など、操作のためのページ
不要なURLがどれだけクロールされているかを確かめる手順は、次の3つです。
Search Consoleの「ページのインデックス登録」で、「検出 - インデックス未登録」のURLの数を、登録済みのページ数と比べます。「検出 - インデックス未登録」の方が多ければ、Googleが見つけたURLにクロールが追いついていない状態です。
クロールの統計情報レポートは、ドメインプロパティか、ルートのURLプレフィックスのプロパティでだけ使えるレポートです。「設定」の「クロールの統計情報」で、レスポンス別や目的別のサンプルURLに、パラメータ付きのURLやリダイレクトが多くないかを見ます。
GooglebotがリクエストしたURLは、サーバーログでテンプレートとパラメータの種類ごとに数えます。クロールの統計情報のサンプルURLは代表例で全件ではなく、Search ConsoleではクロールをURLやパスで絞り込めないためです。Googlebotを名乗る偽のアクセスもあるので、Googleが公開している逆引きDNSかIPアドレスの範囲で確かめてから数えるのが確実です。
クロールの統計情報レポートでは、サーバー側のリダイレクトの途中のURLも1回ずつリクエストとして数えられます。サーバー側のリダイレクトが2回続くURLは、1ページを読むのに3回のリクエストを使っている計算です。
どのテンプレートが不要なURLを生んでいるか、洗い出せていますか
データベースSEOは、数千〜数万ページ規模のデータベース型サイト向けのSEOです。内部リンクとURLの設計を見直す構造の最適化から、sitemapとcanonicalによるインデックスの制御まで行います。
クロールの無駄を減らす3つの手順
クロールの無駄を減らす手順は3つで、URLの数を減らす手順から始めます。先にURLを減らしておけば、テンプレートやサイトマップで扱うURLも少なくなるためです。
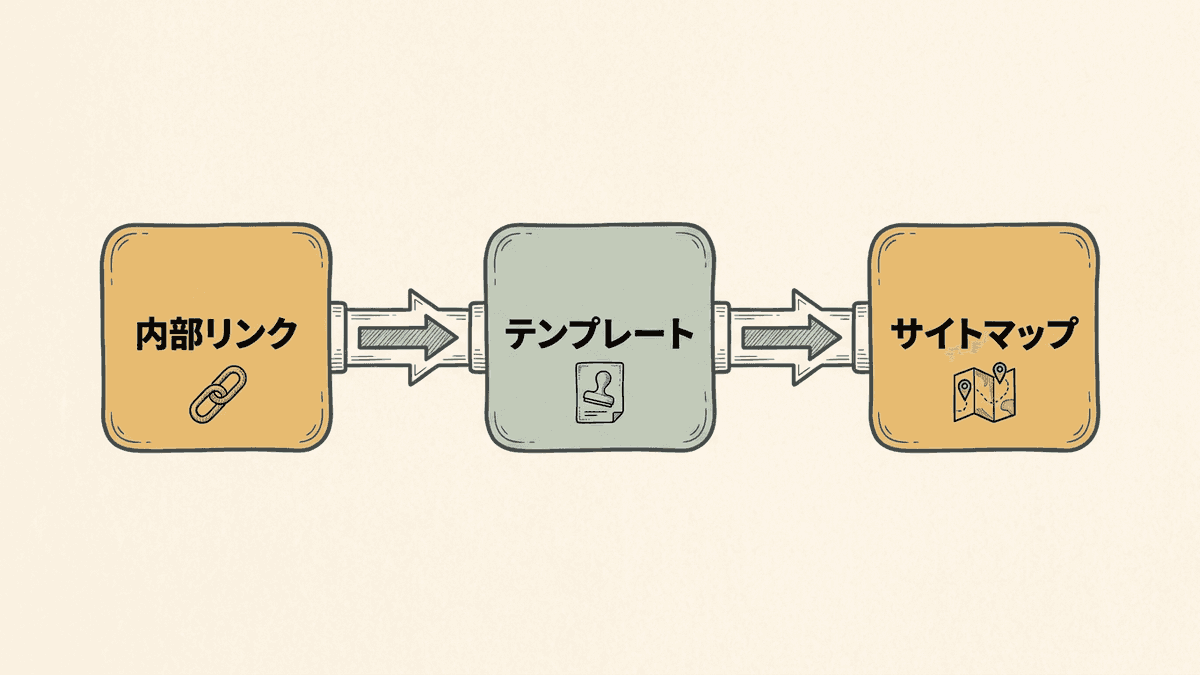
URLと内部リンクの見直し
URLと内部リンクの見直しでは、1つの内容に1つのURLだけが存在し、サイト内のリンクがすべてそのURLを指す状態にします。確かめる項目は次の6つです。
- 内部リンクを、重複したURLでなく正規URLに向ける
- 一覧から詳細ページへは、Googleが辿れる標準のaタグでリンクする
- インデックスに不要な絞り込みは、パラメータでなくURLフラグメント(#以降)で表す
- 絞り込みをパスで表すなら、条件の並び順を固定し、同じ条件を重ねない
- パラメータの区切りには「&」を使う
- リダイレクトする旧URLへのリンクは、最終のURLに張り替える
Googleは通常、URLフラグメントをクロールやインデックス登録に使わないため、フラグメントで表した絞り込みはクロールに影響しません。トップページから直接リンクしたページは重要と見なされ、クロールの頻度が上がる可能性があるとも説明されています。ただし、順位が上がるわけではありません。
テンプレートの出力の修正
テンプレートの出力の修正では、ページの種類ごとに、返すステータスコードと出力するタグを直します。1か所の修正が、同じテンプレートを使う全ページに反映されるのが利点です。直す項目は次の6つです。
- 結果が0件の絞り込み:「見つかりません」と表示し、404を返す
- 存在しないページ番号:404を返す
- 削除したデータのページ:404か410を返す
- 正規ページ:自分自身を指すcanonicalタグを出力する
- 絞り込みのページ:絞り込みの無いページを指すcanonicalタグを出力する
- CSSやJavaScript:全ページで同じURLから読み込む
0件の絞り込みを、汎用の「見つかりません」ページへリダイレクトすることも、Googleは避けるよう求めています。CSSやJavaScriptを全ページで同じURLから読み込むと、Googleは同じファイルを何度もリクエストせず、キャッシュして使い回せます。
ページの読み込みとレンダリングを速くするのも、Googleが同じ時間に読めるページを増やす方法です。とはいえ、品質の低いページを速くしただけでクロールが増えることはない、とGoogleは書いています。
サイトマップに載せるURLの絞り込み
サイトマップには、検索結果に出したいURLだけを載せます。Googleによれば、検索結果に出したくないURLをサイトマップに入れると、クロールバジェットが無駄になる可能性があるためです。
データベース型サイトでは、サイトマップをテンプレートの種類ごとに分けておくと、ページのインデックス登録レポートをサイトマップごとに絞り込めます。1つのサイトマップに載せられるのは50,000件、圧縮前で50MBまでです。超えるときは分割し、サイトマップインデックスファイルにまとめて送ります。
lastmodには、本文や構造化データ、リンクなどを変えた日時を入れます。Googleは、lastmodの値が一貫して正確だと確かめられるときに使うとしており、著作権表記の年を変えただけの日時は重要な更新に当たりません。変更のないサイトマップを1日に何度も送ることも、サイトマップを入れ替えて割り当てを動かすことも、Googleは避けるべきこととして挙げています。
不要なURLを扱う4つの方法の違い
不要なURLを扱う4つの方法の違いは、クロールが減るかどうかと、検索結果から外れるかどうかの2点です。
方法 | Googleのクロール | 検索結果 | 向いているURL |
|---|---|---|---|
canonicalタグ | 重複したURLのクロールが時間をかけて減ることがある | 正規URLにまとまりやすい | 並べ替えや絞り込みで中身が重なるページ |
robots.txt | 止まる | 内容なしで登録されることがある | 検索に出す必要のない絞り込み、カート、サイト内検索の結果 |
noindex | 続く | 外れる | 利用者には必要だが、検索に出したくないページ |
404・410 | 再クロールしないよう強く伝わる | 外れる | 削除したページ、結果が0件の絞り込み |
検索に出す必要のない絞り込みのURLは、canonicalタグで済ませず、robots.txtかURLフラグメントでクロールさせないようにします。Googleによれば、canonicalタグは長期的にはこの2つより効果が低い傾向があるためです。
 Web担当者
不要なページにはnoindexを付けておけば、クロールバジェットの節約になりますよね?
 Writers-hub
編集部
Googleはnoindexを読むためにページをクロールするので、クロールはすぐには減りません。クロールさせたくないURLはrobots.txtで止め、検索結果から外したいURLにはnoindexを使う、と分けて考えてください。
robots.txtを使うのは、長い期間クロールさせたくないURLだけです。Googleは、robots.txtに行を足したり外したりしてクロールバジェットを他のページへ回す使い方を避けるよう求めています。クロール能力の上限に達していない限り、空いた分は他のページに回りません。
robots.txtでブロックしたURLに書いたnoindexは、Googleがページを読めないため効きません。同じURLにrobots.txtとnoindexを重ねないようにします。
クロールバジェットのよくある質問
クロールバジェットの増やし方、順位との関係、数えられるURLの範囲、nofollowの扱いについて、4つの質問に答えます。
クロールバジェットは増やせる?
クロールバジェットは、Googleに頼んで増やすことはできません。Googleはクロール頻度についてのページで、クロール頻度の増加をリクエストすることはできないと説明しています。Googleが挙げる増やし方は2つで、サーバーの容量不足でクロールできないときのリソースの追加と、Google検索に合わせたコンテンツの品質の向上です。容量が足りないことの目安の1つは、URL検査ツールに「ホスト負荷が制限を超えています」と表示されることです。
クロールが増えると順位は上がる?
クロールの回数が増えても、それだけで検索順位が上がることはありません。Googleは、クロールは検索結果に表示されるために必要なものの、ランキングのシグナルではないと説明しています。
CSSやJavaScriptも数に入る?
CSSやJavaScriptも、Googlebotがクロールすればクロールバジェットに数えられます。Googleによれば、クロールされるURLは一般にすべて数えられ、XHRによる取得や、AMPやhreflangの代替URLも対象です。
nofollowを付ければクロールされない?
nofollowを付けたリンクの先も、サイトの別のページやほかのサイトからnofollowなしでリンクされていれば、クロールされます。Googleは、nofollowで効果を得るには、リンク先のURLを指すすべてのリンクに付ける必要があるとしています。
まとめ|クロールバジェットは増やすより無駄を減らす
クロールバジェットは、Googleに頼んで増やせるものではありません。Googleが管理を勧めるのは、100万ページ以上で週1回、または1万ページ以上で毎日更新されるサイトと、「検出 - インデックス未登録」が大半を占めるサイトです。当てはまらなければ、サイトマップを最新に保ち、ページのインデックス登録レポートを見るだけで足ります。
数千〜数万ページのデータベース型サイトで「検出 - インデックス未登録」が多いときは、クロールの統計情報レポートとサーバーログを見てください。先に減らすのは、テンプレートが自動で作る不要なURLです。
私たち合同会社Writers-hubは、数千〜数万ページ規模のデータベース型サイト向けのSEOとして、データベースSEOを提供しています。
テンプレートとサイトマップ、どこから直すか決まっていますか
データベースSEOでは、内部リンクとURLの設計を見直す構造の最適化、title・meta description・構造化データをページの種類ごとに整えるテンプレートの最適化、sitemapとcanonicalによるインデックスの制御を行います。