「不要なURLは、robots.txtとnoindexの両方で止めておけば確実そう」。robots.txtの「disallow」もnoindexも、検索エンジンを締め出す指定に読めるため、2つを重ねれば漏れがなくなると考えられがちです。ところが、robots.txtが止めるのはクロールで、noindexが止めるのはインデックスへの登録です。robots.txtでクロールを止めたURLでは、ページに書いたnoindexをGoogleが読めず、URLが検索結果に残ることがあります。
本記事では、2つの指定の違いから、URLの種類ごとの使い分け、検索結果に出ているURLを外す順番まで、大規模サイトのインデックスの制御を支援する立場で順を追ってお伝えします。
- robots.txtはクロールを止め、noindexはクロールさせたうえでインデックスへの登録を止める
- 同じURLにrobots.txtとnoindexを重ねると、noindexがGoogleに読まれない
- 検索結果に出さないURLのうち、数が多くクロールを減らしたいものはrobots.txt、数が限られるものはnoindexを使う
- 検索結果に出ているURLは、noindexで外れたのを確かめてからrobots.txtで止める
robots.txtとnoindexの違い
robots.txtとnoindexの違いは、Googleの処理のどの段階を止めるかです。robots.txtはクロールを、noindexはインデックスへの登録を止めます。
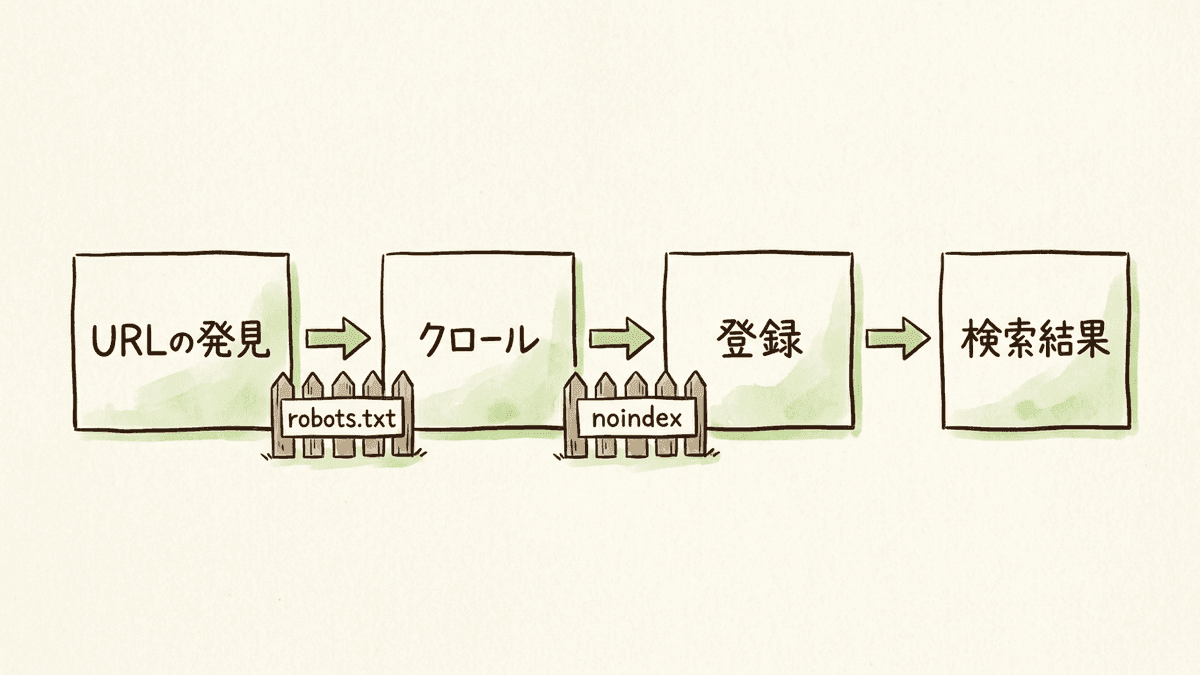
2つの指定の違いを6つの項目で比べると、次のとおりです。
比べる項目 | robots.txt | noindex |
|---|---|---|
止めるもの | クロール | インデックスへの登録 |
書く場所 | サイトのルートのrobots.txt | ページのmetaタグか、HTTPレスポンスヘッダー |
指定の単位 | パスのパターン | ページやファイル |
Googleのクロール | 止まる | 続く |
検索結果 | 他のページからリンクされたURLは、説明文なしで出ることがある | Googleがnoindexを読んだ後に出なくなる |
人のアクセス | 止められない | 止められない |
noindexはGooglebotがページを取得してから効くため、noindexを付けてもクロールの量は減りません。Googleも、クロールを減らしたいURLにnoindexを使うと、クロールの時間が無駄になると説明しています。
robots.txtにはクロールを止めるパスを、metaタグにはnoindexを、次のように書きます。
user-agent: *
disallow: /search/<meta name="robots" content="noindex">metaタグを置く場所や、HTTPレスポンスヘッダーとCMSでの設定は、noindexの書き方と設定方法の記事にまとめています。
robots.txtとnoindexを重ねない理由
robots.txtとnoindexを同じURLに重ねてはいけないのは、robots.txtで止めたURLのnoindexを、Googleが読めないからです。Googleは、noindexを効かせるには、robots.txtでページをブロックせず、クローラーがページにアクセスできるようにする必要があると説明しています。
noindexが読まれないURLは、他のページからリンクされていれば、検索結果に出続けることがあります。
※ 出典:Google 検索セントラル「noindex を使用してコンテンツをインデックスから除外する」
重ねたURLが検索結果に出ていると、Search Consoleのページのインデックス登録レポートに「robots.txt によりブロックされましたが、インデックスに登録しました」と表示されます。
robots.txtとnoindexの選び方
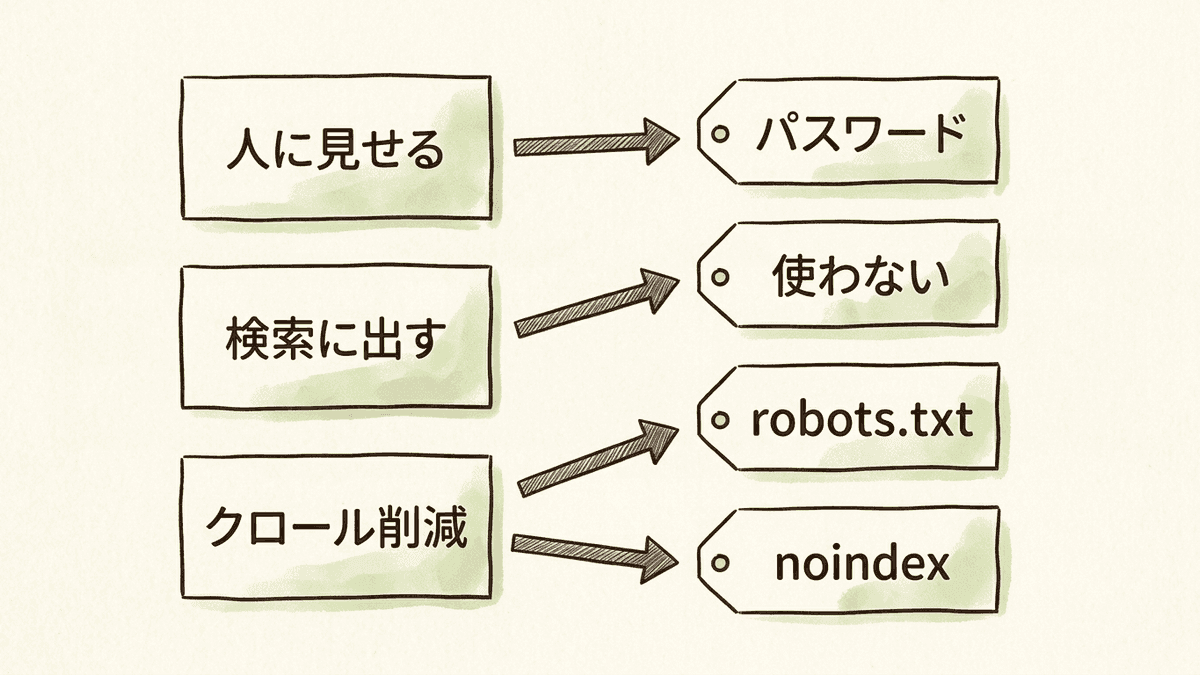
robots.txtとnoindexのどちらを使うかは、URLについて次の3つを順に確かめて決めます。
社外に出せない情報や公開前のページは、robots.txtでもnoindexでも隠せないため、パスワードかログインで保護します。
検索結果に出すURLには、どちらも使いません。同じ中身のページが別のURLにもある重複は、canonicalタグで正規URLを示します。Googleは、正規URLを決める目的でrobots.txtを使うことも、サイト内の重複をnoindexで外すことも勧めていません。
検索結果に出さないURLのうち、数が多く、Googlebotのアクセスそのものを減らしたいURLはrobots.txtで止めます。数が限られ、検索結果から外せれば足りるURLには、noindexを付けます。
robots.txtで止めるのは、長い期間クロールさせないURLだけです。Googleは、クロールに使う時間を一時的にほかのページへ回す目的で、robots.txtを使わないよう求めています。クロールの時間の仕組みは、クロールバジェットの仕組みと目安の記事で扱っています。
大規模サイトのURLの種類ごとの使い分け
数千〜数万ページのサイトでは、robots.txtとnoindexを、URLを作るテンプレートとパラメータの種類ごとに決めます。1つのテンプレートに入れた設定が、そのテンプレートが出力するすべてのURLに当たるためです。データベース型サイトでよく出るURLの種類と、使う指定は次の8つです。
URLの種類 | 使う指定 | 理由 |
|---|---|---|
詳細ページと、検索される一覧ページ | どちらも使わない | 検索結果に出すURLなので、sitemapに載せてクロールさせる |
並べ替えや表示件数のパラメータが付いたURL | robots.txt | 並びが違うだけのURLが、組み合わせの数だけ増える |
検索されない絞り込みの組み合わせのURL | robots.txt | インデックスに要らない絞り込みは、クロールを防ぐようGoogleが勧めている |
サイト内検索の結果ページ | robots.txt | 入力された語の数だけURLが増える |
申し込み完了ページなど、人には要るが検索結果に出さないページ | noindex | 数が少なく、クロールの量に響かない |
計測用のパラメータが付いたURL | canonicalタグ | 中身が正規URLと同じ重複にあたる |
削除した詳細ページ | 404か410 | 再びクロールしないようGoogleに伝わる |
PDFなどHTML以外のファイル | X-Robots-Tagのnoindex | metaタグを書く場所が無い |
とりわけ見落とされがちなのが、掲載を終えた詳細ページの扱いです。
 経営者
掲載が終わった物件のページは、noindexを付けて残しておけばよいですか?
 Writers-hub
編集部
ページを削除するなら、noindexでなく404か410を返してください。Googleは404を、そのURLを再びクロールしないよう求める強いシグナルとして扱います。「掲載終了」とだけ表示して200を返すページは、ソフト404と判定されるとクロールされ続けます。
検索結果に出ているURLを外す順番
検索結果に出ているURLを外し、クロールも減らしたいときの手順は4つです。noindexで検索結果から外れたのを確かめてから、robots.txtに足します。
すでにdisallowで止めているURLは、その行を外して、Googlebotがアクセスできる状態に戻します。Googleはrobots.txtをキャッシュし、24時間おきに更新します。急ぐときは、Search Consoleのrobots.txtレポートから再クロールをリクエストします。
テンプレートで、metaタグかX-Robots-Tagのnoindexを出力します。URL検査ツールで、Googlebotが取得したHTMLにnoindexが入っているかを確かめます。
noindexは、Googlebotが次にそのURLをクロールしたときに読まれます。重要度の低いページは、次のクロールまで数か月かかることがあります。
検索結果から外れた後もクロールを減らしたいURLに、disallowを足します。Googleは、robots.txtで止めたURLでも、他のサイトからリンクされていればインデックスに登録することがあるとしています。外部からリンクされているURLは、robots.txtで止めず、noindexのまま残します。
URL検査ツールで再クロールを頼めるのは1件ずつなので、数万件のURLでは、サイトマップを送信して再クロールを促し、Googlebotが次にクロールするのを待ちます。急いで検索結果から隠したいURLには、Search Consoleの非表示ツールを使います。非表示ツールは1日以内に検索結果から隠せますが、効果は約6か月で切れるため、その間にnoindexを付けるかページを削除します。
外したいURLが、どのテンプレートから出ているか分かっていますか
データベースSEOは、数千〜数万ページ規模のデータベース型サイト向けのSEOです。テンプレートが出力するURLのうち検索結果に出すものをURLの設計で決め、クロールバジェットの配分・sitemap・canonicalでインデックスを制御します。
設定が効いているかの確かめ方
robots.txtとnoindexが効いているかは、Search Consoleのページのインデックス登録レポートで、URLが登録されなかった理由と、警告の表示を見て確かめます。Googleのヘルプにある見出しで、見る表示は次の3つです。
表示 | Googleから見た状態 | 意図と違うときにすること |
|---|---|---|
URL が robots.txt によってブロックされています | robots.txtでクロールが止まっている | robots.txtのdisallowの行を見直す |
URL に noindex が指定されています | noindexを読み、インデックスに登録していない | テンプレートのnoindexの出力条件を見直す |
robots.txt によりブロックされましたが、インデックスに登録しました | クロールを止めたURLが検索結果に出ている | 外すならdisallowを外してnoindexを付ける |
大規模サイトでは、表示ごとに並ぶURLの例を開き、どのテンプレートのURLかで分けて見ます。詳細ページのURLがnoindexの表示に並んでいたら、テンプレートの出力を直します。テンプレートが、公開中のページにもnoindexを出力しているためです。
robots.txtとnoindexのよくある質問
robots.txtとnoindexについて、3つの質問に答えます。
robots.txtにnoindexは書ける?
robots.txtにnoindexと書いても、Googleには効きません。Googleは2019年9月1日に、robots.txtの中のnoindexなど、サポートしていないルールを処理するコードを廃止しました。インデックスから外すには、metaタグかX-Robots-Tagでnoindexを指定します。

※ 出典:Google 検索セントラル ブログ「robots.txt のサポートされていないルールに関する注意事項」
noindexにnofollowも付けるべき?
nofollowはページ上のリンクをたどらないよう伝える指定で、noindexと一緒に付ける必要はありません。noindexの一覧ページから詳細ページへリンクしているなら、nofollowは付けません。nofollowを付けると、Googleが一覧のリンクから詳細ページを見つけられなくなるためです。
PDFや画像を検索結果から外すには?
PDFは、HTTPレスポンスヘッダーのX-Robots-Tagでnoindexを返します。Googleは、PDFを検索結果に出さない目的でrobots.txtを使わないよう求めています。画像や動画などのメディアファイルは、robots.txtで止めると検索結果に出なくなります。
まとめ|止めたいものでrobots.txtとnoindexを選ぶ
robots.txtはGooglebotのクロールを止め、noindexはクロールさせたうえでインデックスへの登録を止めます。同じURLに両方を書くと、Googlebotがnoindexを読めず、URLが検索結果に残ることがあります。
検索結果から外すならnoindex、クロールを減らすならrobots.txtを使います。大規模サイトでは、テンプレートとパラメータの種類ごとにどちらを使うかを決め、検索結果に出ているURLは、noindexで外れたのを確かめてからrobots.txtで止めます。
私たち合同会社Writers-hubは、数千〜数万ページ規模のデータベース型サイトを対象に、データベースSEOを提供しています。
robots.txtとnoindexの設定が、テンプレートごとにばらばらになっていませんか
データベースSEOでは、内部リンクとURLの設計を見直す構造の最適化と、クロールバジェットの配分・sitemap・canonicalによるインデックスの制御を行います。title・meta description・構造化データも、ページの種類ごとに整えます。