「自己参照canonicalは、とりあえず全ページに入れておけば安心」。Google検索セントラルの説明にも、正規ページ自体にcanonicalを含めるよう書かれているため、どのページにも同じように入れるのが決まりだと思われがちです。ところが、同じ説明には正規URLの指定は必須ではないとも書かれており、パラメータ付きのURLまで自分自身を指していると、正規ページを1つに示せません。大規模サイトで先に決めるのは、canonicalにどのURLを出すかです。
本記事では、Googleの公式ドキュメントの記述から、ページの種類ごとのcanonicalの出し方、noindexとの併用の扱いまで、データベース型サイトのSEOを手がける会社の視点で順を追ってお伝えします。
- 自己参照canonicalは、Googleが正規ページに入れるよう勧めているが、必須ではない
- 自分自身のURLを指すのはインデックスさせたいページで、パラメータ付きのURLは正規ページを指す
- noindexと自己参照canonicalの併用の扱いは、Googleの公式ドキュメントに書かれていない
- 重複ページの評価をまとめるのはcanonicalで、noindexを代わりに使わない
- canonical、sitemap、内部リンクには、同じ処理で組み立てた正規URLを出す
自己参照canonicalは必須か
自己参照canonicalは勧められていますが、必須ではありません。自己参照canonicalとは、ページのhead内に、そのページ自身のURLを正規URLとして書いたcanonicalのことです。
Googleは、rel="canonical" などを利用して正規 URL を指定する方法のベストプラクティスで、正規ページ自体にcanonicalを含めるよう勧めています。同じページには、正規URLの指定がなくても、Googleが検索結果に表示するのに最適なURLを判断すると書かれています。
ページの種類ごとのcanonicalの出し方
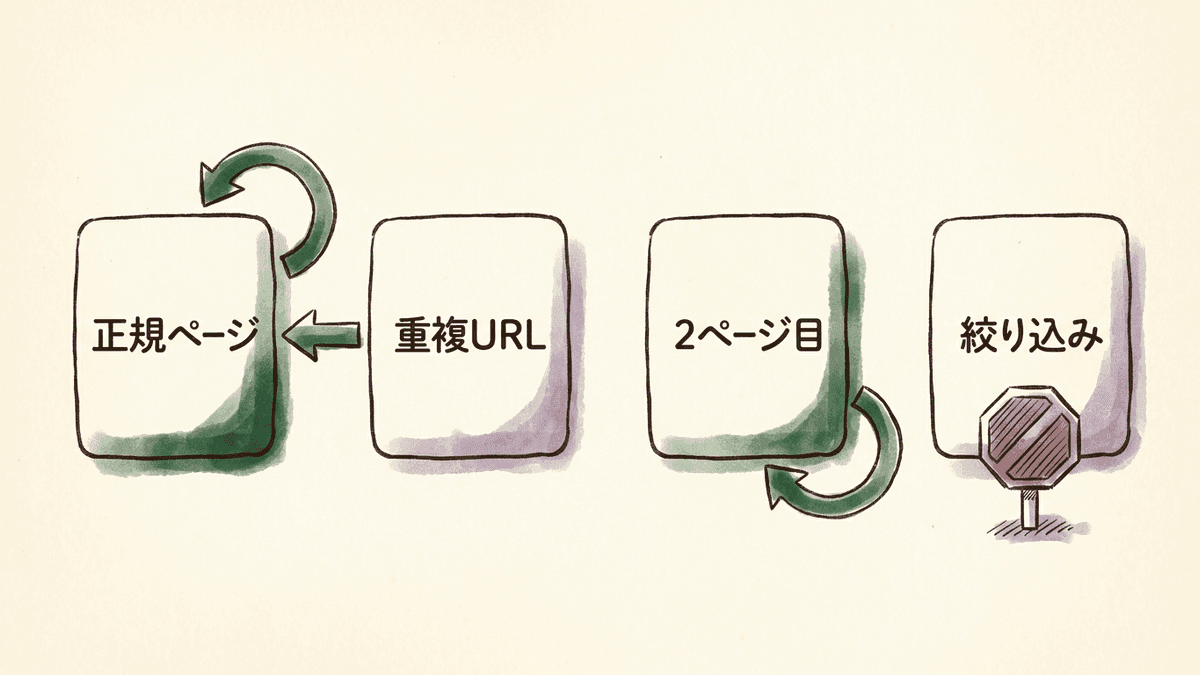
大規模サイトで自己参照canonicalを付けるかは、ページの種類ごとに、そのURLを検索結果に出したいかで決まります。データベース型サイトの主な4つの種類と、canonicalに出すURLは次の表のとおりです。
ページの種類 | canonicalに出すURL |
|---|---|
インデックスさせる正規ページ | そのページ自身のURL |
パラメータ付きの重複URL | 正規ページのURL |
一覧の2ページ目以降 | そのページ自身のURL |
絞り込み条件付きのURL | 検索結果に出すならそのページ自身のURL、出さないならrobots.txtでクロールを止める |
インデックスさせる正規ページ
インデックスさせる正規ページには、そのページ自身のURLを絶対パスで書いたcanonicalを出します。クライアントサイドレンダリングを使うサイトでは、HTMLのソースコードにcanonicalを書き、JavaScriptで書き換えないのが最善とされています。
テンプレートが、開かれたURLをそのままcanonicalに出していると、パラメータ付きのURLがどれも自分を正規URLとして示します。canonicalのURLは、開かれたURLからではなく、データベースのIDやスラッグから組み立てます。
パラメータ付きの重複URL
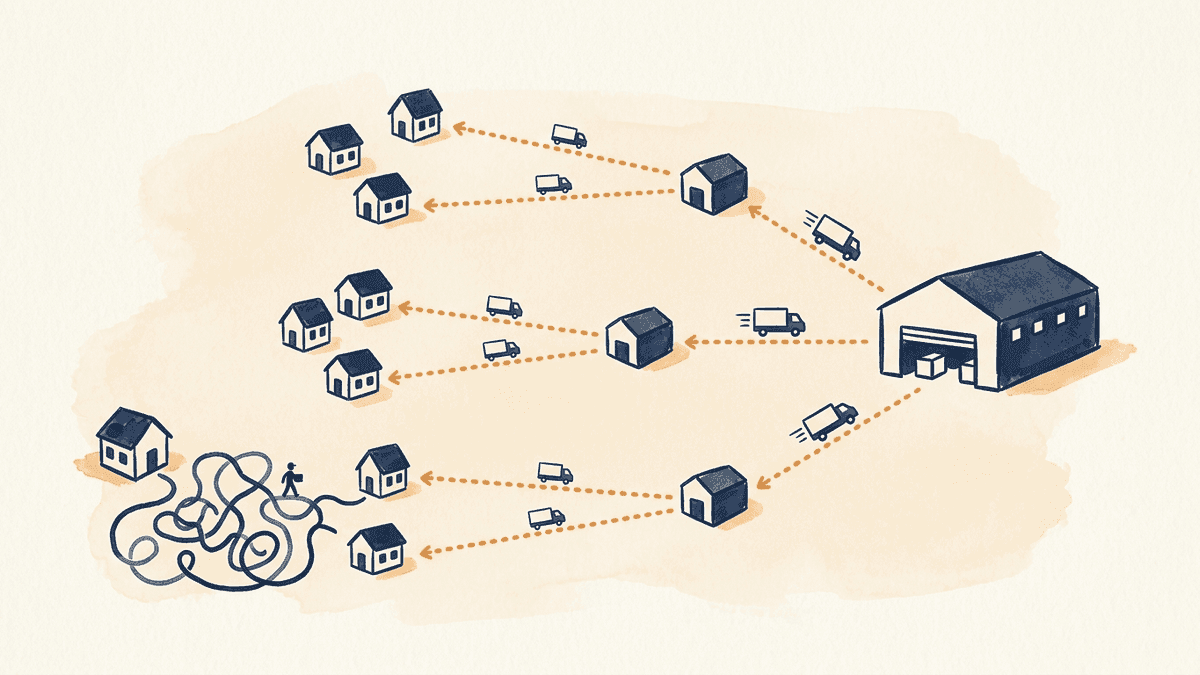
計測用や並び替えのパラメータが付いたURLには、自己参照ではなく、正規ページのURLを出します。Googleは、正規URLを指定する理由の1つに、重複ページへのリンクなどのシグナルを1つのURLにまとめることを挙げています。
一覧の2ページ目以降
一覧の2ページ目以降には、1ページ目ではなく、そのページ自身のURLをcanonicalに出します。Googleのページネーションの説明には、一連のページの1ページ目を正規ページとして使わず、各ページに固有の正規URLを付けるよう書かれています。
「?page=2」のように、ページごとに一意のURLを割り当てれば、Googleは各URLを別のページとして扱います。
絞り込み条件付きのURL
絞り込み条件付きのURLは、検索結果に出す必要があるかで扱いが分かれます。Googleのファセットナビゲーションのクロール管理の説明では、インデックスさせる必要がない絞り込みのURLは、robots.txtでクロールを防ぐ方法が勧められています。
同じ説明には、canonicalで絞り込みのないURLを指す方法も挙げられています。ただし、非正規のURLのクロールが時間とともに減る可能性はあるものの、長期的にはrobots.txtなどより効果が低い傾向があるとされています。robots.txtでブロックしたURLは、Googleがページを取得しないので、ページに書いたcanonicalも読まれません。
地域とカテゴリの組み合わせのように、絞り込みのURLを検索結果に出すページとして作るなら、正規ページとして自己参照canonicalを出します。絞り込みのURLが増えたときのクロールの扱いは、クロールバジェットの記事で紹介しています。
noindexと自己参照canonicalの併用
noindexと自己参照canonicalを同じページに併用したときの扱いは、2026年10月時点のGoogleの公式ドキュメントには書かれていません。noindexの説明にも、正規URLの指定方法の説明にも、併用を認める記述と禁じる記述のどちらもありません。
併用を判断する材料は、2つの指定の役割の違いです。canonicalは、重複や類似のページの中で、どのURLを代表にしてほしいかを伝える指定です。noindexは、Googlebotが検出すると、ほかのサイトからリンクされていてもページを検索結果から完全に削除するルールです。
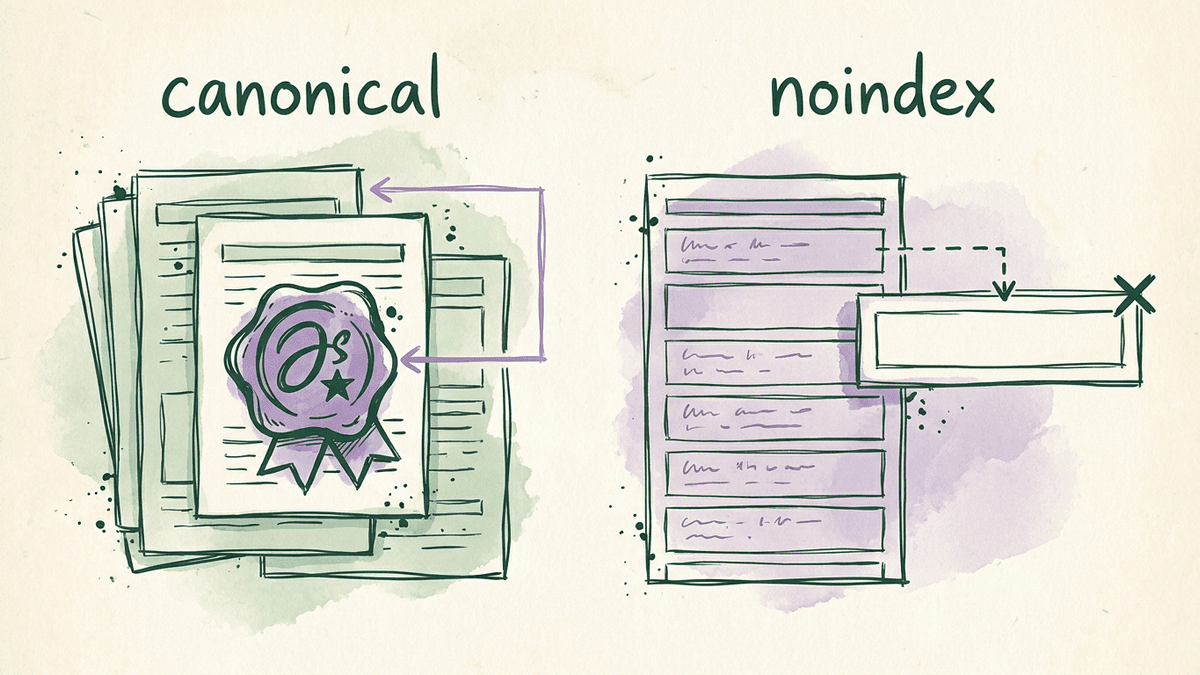
検索結果から外したいページには、noindexを付けます。自己参照canonicalは、ページを検索結果から外す働きを持ちません。
ただし、noindexのページに自己参照canonicalを出すと、canonicalの指定先がnoindexのページ自身になります。Googleは2013年の公式ブログで、canonicalの指定先にnoindexが付いていないかを確かめるよう挙げています。noindexにするページでは、自己参照canonicalを出さないテンプレートにすると、この状態を避けられます。
canonicalとnoindexの3つの注意点
canonicalとnoindexを組み合わせるときは、次の3つの状態を避けます。
- canonicalの指定先が、noindexを付けたページになっている
- 重複ページの評価をまとめるために、noindexを付けている
- noindexを付けたページを、robots.txtでもブロックしている
canonicalの指定先がnoindexのページだと、代表にしてほしいURLを、検索結果から外すよう同時に伝えることになります。1つのサイトの中で、正規ページを選ばせる目的で重複ページにnoindexを付ける使い方は、ページが検索結果から完全にブロックされるため、Googleは勧めていません。
robots.txtでブロックしたページでは、Googleがnoindexを読めません。Googleの説明では、そのページがほかのページからリンクされていれば、検索結果に表示され続ける可能性があります。
 経営者
絞り込みのURLが多すぎるので、noindexを付けてクロールを減らせないでしょうか?
 Writers-hub
編集部
クロールを減らしたいなら、noindexではなくrobots.txtを使います。Googleのクロールバジェットのガイドには、noindexを付けてもGoogleはURLをリクエストし続けるので、クロールの時間が無駄になると書かれています。
canonicalと同じURLを出す2つの場所
大規模サイトでは、canonicalに出す正規URLと同じURLを、sitemapと内部リンクにも出します。Googleは、rel="canonical"とsitemapのように、正規化の方法を2つ以上組み合わせると、希望する正規URLが検索結果に表示される可能性が高くなると説明しています。
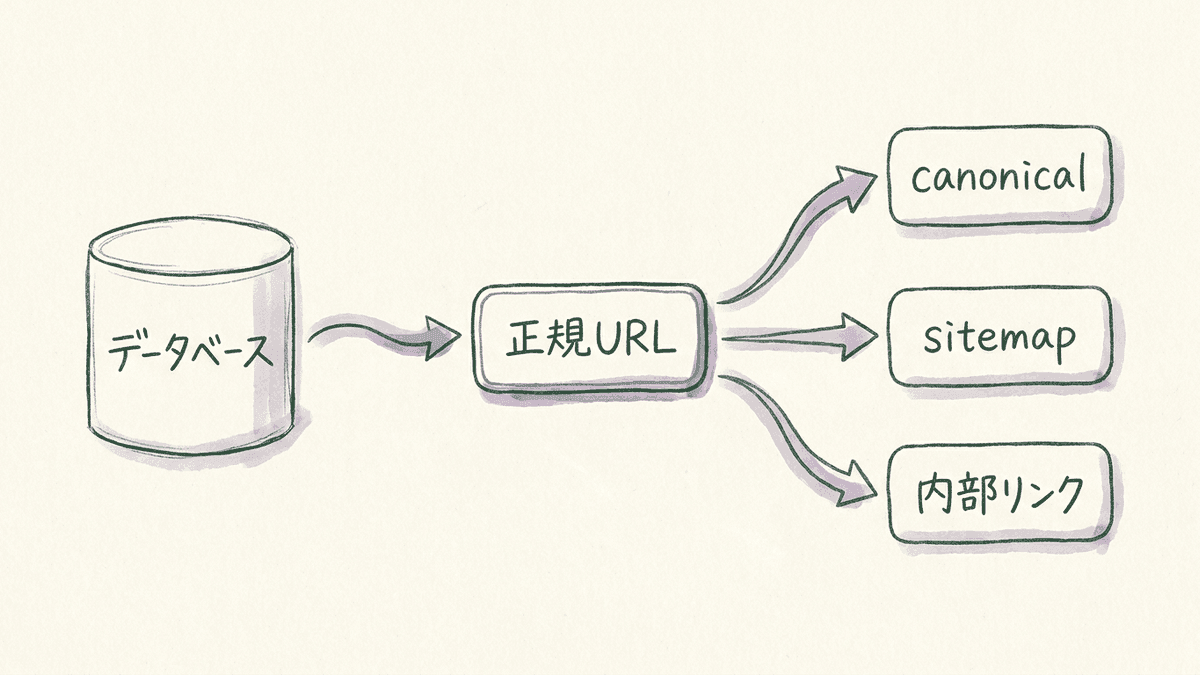
実装では、データベースの行から正規URLを組み立てる処理を1つだけ作り、canonical、sitemap、内部リンクの3つで同じ処理を使います。テンプレートごとにURLを組み立てる処理が分かれていると、どれか1つだけ直したときにURLが食い違うためです。
sitemapに載せるURL
sitemapには、canonicalが自分自身を指しているURLだけを載せます。Googleの説明では、sitemapに含めたページはすべて正規ページの候補として示され、sitemapとcanonicalで同じページの別のURLを指定しないよう求められています。
パラメータ付きのURLやnoindexのページをsitemapに載せると、sitemapとページの指定が食い違います。
内部リンクのURL
内部リンクには、重複URLではなく正規URLを使います。Googleは、正規URLに一貫してリンクすると、どのURLを正規にしたいかがGoogleに伝わりやすくなると説明しています。
データベース型サイトでは、パンくずリストや関連する詳細ページへのリンクのように、テンプレートが自動で出す内部リンクが多くあります。テンプレートがパラメータを付けたままリンクを出していると、canonicalで正規ページを指していても、サイトの中から重複URLへのリンクが増え続けます。
canonical、sitemap、内部リンクのURLが、テンプレートごとに食い違っていませんか
データベースSEOでは、数千〜数万ページ規模のデータベース型サイトを対象に、内部リンクとURLの設計と、sitemapやcanonicalによるインデックスの制御を行います。
Googleが選んだ正規URLの確かめ方
Googleが自己参照canonicalのとおりに正規URLを選んでいるかは、Search ConsoleのURL検査ツールで確かめます。Googleは正規化に関する問題の修正で、正規ページを明示しても、コンテンツの品質や技術的なシグナルなどの理由から、別のページを正規として選ぶことがあると説明しています。数万ページを1件ずつは見られないので、次の4つの手順でテンプレートごとに確かめます。
詳細ページ、一覧の1ページ目と2ページ目、検索結果に出す絞り込みのページのように、テンプレートの種類ごとに数件のURLを選びます。
選んだURLに計測用のパラメータを付けて開き、HTMLのソースコードにあるcanonicalが、パラメータの無い正規URLのままかを見ます。
URL検査ツールで、Googleがどのページを正規ページと見なしているかを調べ、指定したURLと同じかを見比べます。
Googleが別のURLを選んでいたら、まとめて扱われたページどうしの内容の違いを見直します。Googleは、内容を直した後もページを最長2週間は重複のまとまりに残すことがあると説明しています。
内容を直したURLは、URL検査ツールからインデックス登録をリクエストできますが、回数に上限があるため、リクエストは重要なURLだけに使います。指定が反映されない原因を1件ずつ切り分ける順番は、canonicalタグの記事で紹介しています。
自己参照canonicalのよくある質問
自己参照canonicalを全ページに出すときに迷いやすい、3つの質問に答えます。
自己参照canonicalが無いと順位は下がる?
自己参照canonicalが無いことで順位が下がるとは、Googleの公式ドキュメントには書かれていません。指定する利点としてGoogleが挙げるのは、検索結果に表示したいURLを選べることや、重複ページへのリンクなどのシグナルを1つのURLにまとめられることです。
HTMLとHTTPヘッダーの両方で指定していい?
HTMLのlink要素とHTTPヘッダーの両方でcanonicalを指定することを、Googleはかまわないとしています。ただし、2つで別のURLを指定する誤りが起きやすくなるため、どちらか1つで指定するのが基本です。HTTPヘッダーは、PDFのようなHTML以外のファイルに正規URLを示すときに使えます。
多言語サイトではどのURLを指す?
hreflangを使う多言語サイトでは、canonicalに同じ言語の正規ページを指定します。同じ言語の正規ページが無いときは、最適な代わりの言語のページを指定するよう、Googleは求めています。
hreflangなど、ページの別のバージョンを示す属性を付けたcanonicalは、正規化に使われません。言語や国の違うページは、canonicalではなく、rel="alternate"とhreflangで示します。
まとめ|自己参照canonicalはページの種類で出し分ける
自己参照canonicalは、Googleが正規ページに入れるよう勧めていますが、必須ではありません。大規模サイトでは、全ページに同じ形で入れるのではなく、インデックスさせたいページは自分自身のURLを、パラメータ付きの重複URLは正規ページのURLを指すように出し分けます。noindexとの併用は公式に扱いが書かれていないので、2つの指定の役割の違いから組み合わせを決めます。
今日から確かめることは、次の3つです。
- テンプレートが、開かれたURLではなく正規URLをcanonicalに出しているか
- canonicalの指定先に、noindexのページが含まれていないか
- sitemapと内部リンクのURLが、canonicalのURLと同じか
私たち合同会社Writers-hubは、数千〜数万ページ規模のデータベース型サイト向けのデータベースSEOとして、内部リンクとURLの設計、テンプレートの最適化、sitemapやcanonicalによるインデックスの制御を行っています。
ページの種類ごとに、インデックスさせるURLを決めきれていませんか
データベースSEOでは、title・meta description・構造化データをページの種類ごとに整えるテンプレートの最適化も行います。canonicalとあわせて、ページの種類ごとのテンプレートを見直せます。