「文章を写していなければ、似た構成の記事を何本出しても重複コンテンツにはならないはず」。重複コンテンツは他サイトの文章を写した記事の問題として説明されることが多く、コピペチェックの一致率が低ければ問題ないと考えがちです。ところが、Googleが比べるのは各ページのメインコンテンツで、同じに見えるか非常に似通ったページは、写したかどうかに関係なく1つのグループにまとめられます。
本記事では、Googleが重複と判定する基準から、検索結果への影響と直し方、量産する記事で同じ内容が並んでいないかを見るポイントまで、記事を毎日公開している制作会社の視点で順を追ってお伝えします。
- 重複の基準は、Googleがメインコンテンツを比べて同じか非常に似ていると見るかで、何%という数値は無い
- 重複があるだけではペナルティの対象にならず、検索結果には通常Googleが選んだ1ページだけが出る
- 重複したURLは、Search Consoleで見つけ、リダイレクトやcanonicalタグで正規URLにまとめる
- 量産記事は、テンプレートや差し替えた語を除いた本文に、その記事だけの答えがあるかを見る
重複コンテンツと判定される基準
重複コンテンツと判定される基準は、Googleがページのメインコンテンツを比べて、同じに見えるか、非常に似通っていると見るかです。何%一致したら重複になるという数値は、Googleの重複コンテンツに関する文書には書かれていません。
Googleが似たページをまとめる仕組み
Googleは、ページをインデックスに登録するときに、各ページのメインコンテンツを特定します。メインコンテンツが同じに見えるか非常に似通ったページを見つけると、それらを1つのグループにまとめます。
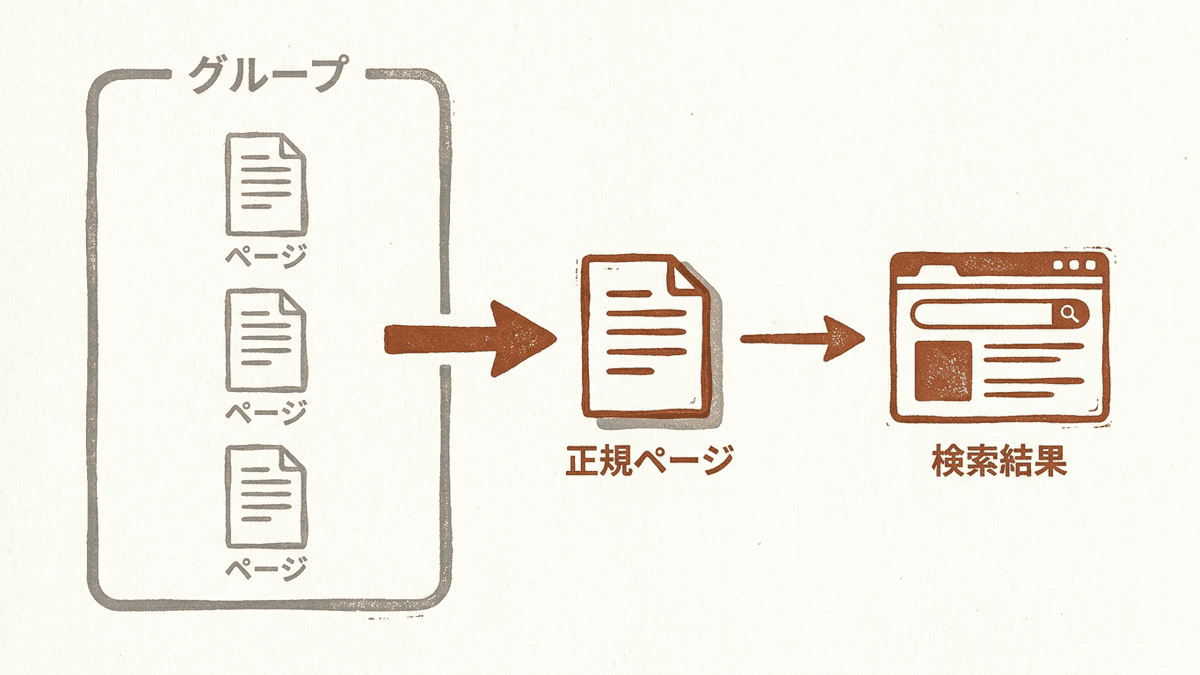
グループの中からは、検索する人にとって最も完成度が高く有用だと判断された1ページが「正規ページ」に選ばれます。
※ 出典:Google検索セントラル「URL 正規化とは何か」
重複になるページとならないページ
重複になるかは、URLや言語が違っても、メインコンテンツが同じかどうかで決まります。
ページの例 | 判定 | 理由 |
|---|---|---|
HTTPとHTTPSの両方で開ける同じページ | 重複 | プロトコルが違うだけで中身が同じ |
並び替えや絞り込みの機能で生まれたURL | 重複 | 同じ一覧を並べ替えただけ |
別のURLにあるモバイル版とPC版 | 重複 | 同じページの端末ごとの版 |
米国向けと英国向けのように地域だけ違う英語のページ | 重複 | 同じ言語の同じコンテンツ |
クローラーがアクセスできる状態で残ったデモ版 | 重複 | 本番のページと中身が同じ |
ヘッダーとフッターだけを翻訳したページ | 重複 | 本文が元の言語のまま |
本文まで翻訳した別の言語のページ | 重複でない | メインコンテンツの言語が元と違う |
表のページは、どれも他のサイトの文章を写したものではありません。文章を写していなくても、メインコンテンツが同じなら重複になります。
重複コンテンツがSEOに与える影響
重複コンテンツがあるだけでは、Googleからペナルティを受けません。Googleは、サイト上で重複コンテンツが発生するのは通常のことで、スパムに関するポリシーの違反にはならないと説明しています。
影響として起きるのは、検索結果に出るページの絞り込みです。Googleは、グループから選んだ正規ページを、コンテンツと品質を評価する主な情報源として使います。検索結果にも、通常は正規ページだけが表示されます。
例外は、グループの中に、検索した人の状況により合うページがあるときです。スマートフォンで検索した人には、PC用のページが正規ページでも、モバイル用のページが表示される可能性が高いとGoogleは説明しています。
Googleの文書では、重複したURLが残ることで起きることがある影響として、ほかに次の3つが挙げられています。
- クロール:重複したURLの巡回に、Googleのクロールの手間が使われる
- 計測:同じ内容へのアクセスが複数のURLに分かれ、成果を追いにくくなる
- 利用者:どれが正しいページか、ページの間に違いがあるかを迷わせる
ペナルティの対象になるのは、検索順位を操作する目的で他のサイトのコンテンツを写す行為などです。Googleのスパムに関するポリシーは、他のサイトのコンテンツを、出典も示さず独自の価値も加えずに転載する「スクレイピング」を違反に挙げています。他サイトの文章を写した記事の扱いは、コピーコンテンツはペナルティの対象か|判定の仕組みとケース別の対処にまとめています。
重複コンテンツの見つけ方とまとめ方
重複コンテンツは、Search Consoleで重複と判定されたURLを見つけ、検索結果に出したい正規URLにまとめて直します。
Search Consoleでの見つけ方
Search Consoleの「ページのインデックス登録」レポートでは、重複と判定されて登録されなかったURLが、次の2つの理由で表示されます。
表示される理由 | 意味 | すること |
|---|---|---|
重複していますが、ユーザーが正規ページとして選択していません | 正規ページを指定していないページを、Googleが別のページの重複と判定した | Googleが選んだ正規URLが希望と違えば、正規URLを指定する |
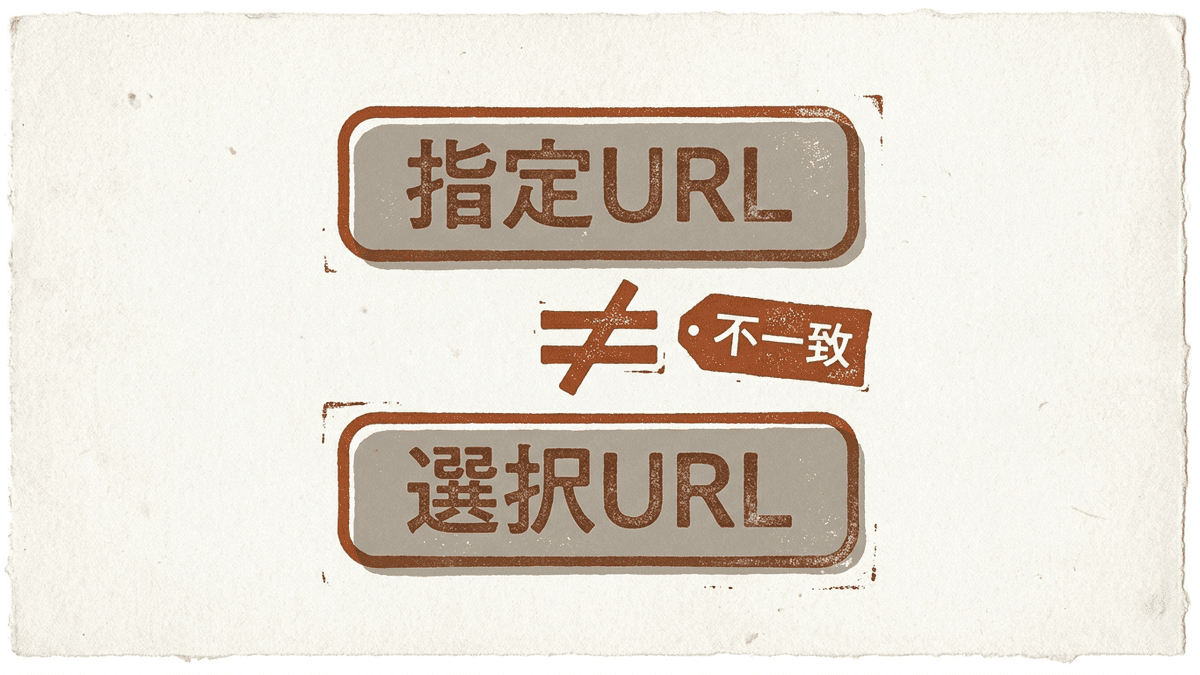
重複しています。Google により、ユーザーがマークしたページとは異なるページが正規ページとして選択されました | 指定した正規URLとは別のURLを、Googleが正規ページに選んだ | 指定した正規URLと重複ページの中身が似ているかを見比べる |
どのURLが正規ページに選ばれたかは、URL検査ツールの「Google が選択した正規 URL」で確かめます。Googleが選んだ正規URLは、インデックスに登録されたデータでだけ確かめられ、公開URLのテストでは確かめられません。
レポートの一覧に出るURLの例は1,000件までで、1,000件未満でもすべてのURLが出るとは限りません。記事の多いサイトでは、検索結果に出したい記事のURLを、URL検査ツールで1本ずつ確かめます。
※ 出典:Search Console ヘルプ「ページ インデックス登録レポート」
正規URLへのまとめ方
重複したURLは、Googleに正規URLを伝える3つの方法でまとめます。正規URLを伝えると、重複したURLへのリンクなどのシグナルが正規URLにまとまり、検索結果に出したいURLをGoogleに示せます。
| リダイレクト | canonicalタグ | サイトマップ | |
|---|---|---|---|
| シグナルの強さ | 強い | 強い | 弱い |
| 使う場面 | 重複ページを廃止するとき | 重複ページを残すとき | 大規模なサイトで正規URLをまとめて示すとき |
Googleは、2つ以上の方法を組み合わせると、希望する正規URLが検索結果に表示される可能性が高くなるとしています。ただし、どの方法も希望を伝える手段で、Googleが別のページを正規ページに選ぶこともあります。サイト内のリンクも、重複したURLでなく正規URLに向けます。
robots.txtとURL削除ツールは、正規URLを決める目的では使いません。robots.txtで拒んだURLは内容の無いまま登録されることがあり、URL削除ツールはURLのすべての版を検索結果から外すためです。
リダイレクトとcanonicalタグの書き分けは、URL正規化とは?301リダイレクトとcanonicalの使い分けを解説にまとめています。
※ 出典:Google検索セントラル「rel="canonical" などを利用して正規 URL を指定する方法」
量産記事で見る4つの確認ポイント
量産記事で同じ内容が並んでいないかは、メインコンテンツの違いを見る4つのポイントで確かめます。Googleは、グループにまとめられたページは、ほかのページとの違いが明確で大きいほど早く別々に扱われると説明しています。本文を書き分けた後も、Googleは重複のグループにページを最長2週間残すことがあります。重要なURLはURL検査ツールからインデックス登録をリクエストできますが、リクエストの回数には上限があります。
テンプレートを除いた本文の違い
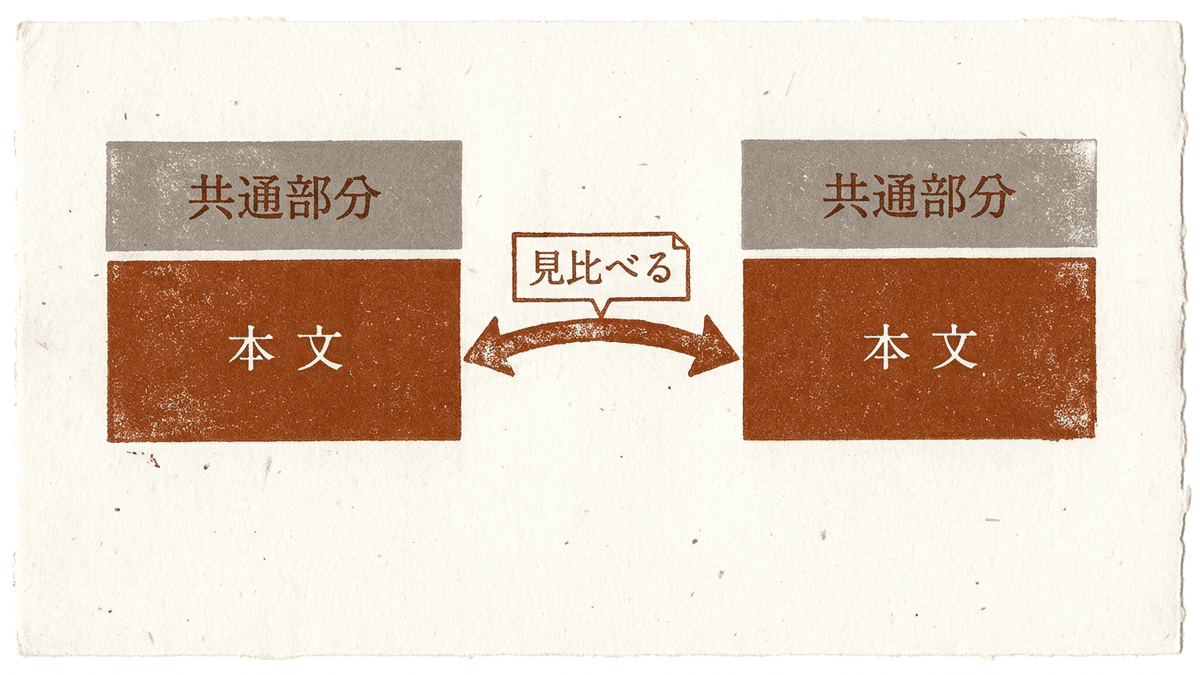
同じテンプレートで作る記事では、共通部分を除いた本文が、記事ごとに別の問いに答えているかを確かめます。
見落とされがちですが、導入の定型文や注意書き、問い合わせの案内の言い回しを記事ごとに変えても、本文が同じなら記事どうしの違いにはなりません。公開前に、同じテンプレートの既存記事と並べ、共通部分を消した本文だけを読み比べます。
地名や商品名を除いた情報の違い
地名や商品名だけを差し替えて作るページでは、差し替えた語を除いたときに、そのページでしか読めない情報が残るかを確かめます。
 Web担当者
市区町村ごとのサービスページを、地名だけ変えて市区町村の数だけ作りました。重複コンテンツと判定されますか?
 Writers-hub
編集部
地名のほかの本文が同じなら、1つのグループにまとめられ、検索結果に出るのはその中の1ページだけになることがあります。市区町村ごとに違う料金や訪問できる範囲があれば、各ページにそれを書いてください。書くことの無い市区町村は、1つのページにまとめて、対応する地域をその中に並べます。
Googleのスパムに関するポリシーは、特定の地域や都市を対象にしたページを複数作り、1つのページに利用者を誘導することを「誘導ページの不正使用」の例に挙げています。検索キーワードを含むだけで、読む人にほとんど意味の無いページを大量に作ることも、「大量生成されたコンテンツの不正使用」の例に入っています。
同じ問いに答える既存記事の有無
KWの表記違いごとに記事を作るときは、同じ問いに答える記事が既にないかを、書く前に確かめます。「重複コンテンツ 基準」と「重複コンテンツ 判定」のように、言葉が違っても答えが同じKWで2本書くと、本文はほとんど同じになるためです。
公開済みと下書きの記事のタイトルとH2を一覧にし、新しい記事の問いに答えている記事があれば、新しく書かずにその記事へ書き足します。同じ問いに答える記事どうしが順位を分け合う問題は、SEOのカニバリを見つけて直す手順|キーワードごとに答えるページを決めるで扱っています。
同じ問いに答える記事が、KWの表記違いで増えていませんか
記事コンテンツの制作支援のKW戦略設計では、検索意図を読み、上位を狙えるKWから優先して取り組むロードマップを作ります。料金は公開しておらず、無料相談(オンライン30分)でお見積もりします。
上位ページに無い情報の有無
検索上位のページを材料に記事を作るときは、上位ページに無い情報を書いた段落を指せるかを確かめます。Googleがコンテンツの自己評価に挙げる問いにも、他のソースを参考にした内容が、単なるコピーや書き換えでなく、付加価値とオリジナリティを示しているかがあります。
スパムに関するポリシーの「大量生成されたコンテンツの不正使用」には、生成AIなどのツールで、利用者にとっての価値を加えずに大量のページを作ることも例に挙げられています。公開前に、上位ページを読んだ人がこの記事で初めて知る情報を段落の単位で書き出し、1つも書き出せない記事は、自社の数字や事例を足してから公開します。
※ 出典:Google検索セントラル「Google ウェブ検索のスパムに関するポリシー」
重複コンテンツのよくある質問
重複コンテンツについて、記事を量産する担当者が迷いやすい3つの質問に答えます。
noindexで重複を消してもいい?
サイト内の重複には、noindexでなく、正規URLを指すcanonicalタグを使います。Googleは、noindexを付けたページはGoogle検索から完全にブロックされるため、正規ページの選択に使うのはおすすめしないとしています。
絞り込みで増えたURLも直すべき?
並び替えや絞り込みで増えたURLは、同じ一覧の見せ方を変えただけなら、インデックスに登録されなくても問題ありません。Googleも、パラメータで並べ替えや絞り込みをしただけのページが登録されないのは妥当だとしています。検索結果に出したい一覧のURLが正規ページに選ばれているかを、URL検査ツールで確かめます。
記事を他サイトに転載してもいい?
自社の記事を提携先などに転載するときは、転載先でインデックス登録をブロックしてもらいます。Googleは、転載先のページは元の記事と大きく異なることが多いため、canonicalタグで元の記事を示す方法を勧めていません。転載先でのブロックが最も効果的な解決策だとしています。
まとめ|重複かどうかはメインコンテンツの違いで決まる
重複コンテンツの基準は、Googleがページのメインコンテンツを比べて、同じに見えるか非常に似通っていると見るかです。重複があるだけではペナルティの対象にならず、検索結果には通常、Googleが選んだ正規ページだけが表示されます。
重複したURLはSearch Consoleで見つけ、リダイレクトやcanonicalタグで正規URLにまとめます。記事を量産するときは、テンプレートや差し替えた語を除いた本文に、その記事だけの答えがあるかを公開前に確かめます。公開済みの記事が多いときは、記事ごとに答えている問いを一覧にしてから見比べると、同じ問いに答える記事を見落としません。
私たち合同会社Writers-hubは、自社と取引先のサイトで記事を毎日公開している制作会社です。
確認ポイントを、書き手が変わっても同じように使いたいときは
記事コンテンツの制作支援では、編集者・ライター・監修者のチーム編成、レギュレーションの策定、品質管理フローの構築を行います。Writers-hubが自社と取引先のサイトで毎日の公開に使っている、記事の指示文を作るツールも、御社で回せる形でお渡しします。公開前の確認は御社で行っていただきます。料金は無料相談(オンライン30分)でお見積もりします。