「Googleにクロールされれば、そのページは検索結果に出そう」。Search Consoleに「前回のクロール」の日時が表示されると、Googleの確認が終わったように見えるため、クロールは検索結果に載るための最後の手続きと受け取られがちです。ところが、クロールはGoogleがページを読みに来る最初の段階にすぎず、検索結果に出るのは、その後Googleのインデックス(検索用のデータベース)に登録されたページだけです。
本記事では、クロールの意味から、自社のページがクロールされたかの確かめ方、クロールしてもらう方法と止める方法まで、企業のオウンドメディアの記事を作ってきた制作会社の視点で順を追ってお伝えします。
- クロールは、検索エンジンのプログラムがページを読みに来て内容を取得すること
- クロールされたページでも、インデックスに登録されなければ検索結果に出ない
- クロールされたかは、Search ConsoleのURL検査ツールで1ページずつ確かめられる
- 数百ページのサイトなら、クロールの回数より内部リンクの有無を先に見る
- 検索結果から外したいページは、robots.txtで止めずにnoindexを使う
クロールの意味とクローラーの関係
クロールとは、Googleなどの検索エンジンのプログラムがWebページを読みに来て、内容を取得することです。
クロールをするプログラムは、クローラーと呼ばれます。Googleのクローラーの名前はGooglebotで、Googleはロボット、ボット、スパイダーも同じものの呼び名として挙げています。
検索結果に出るまでの3つの段階
Googleの検索結果にページが出るまでには次の3つの段階があり、クロールは最初の段階です。
段階 | Googleがすること |
|---|---|
クロール | ページを読みに来て、テキスト、画像、動画を取得する |
インデックス登録 | 取得したページの内容を解析し、Googleのインデックス(検索用のデータベース)に保存する |
検索結果への表示 | 検索した人の語句に合うページを、インデックスの中から選んで表示する |
Googleは、すべてのページが3つの段階を通るわけではないと説明しています。クロールされても、インデックスに登録されなければ検索結果には出ません。インデックスに登録されるかどうかは、ページの内容の品質や、ほかのページとの重複でも左右されます。
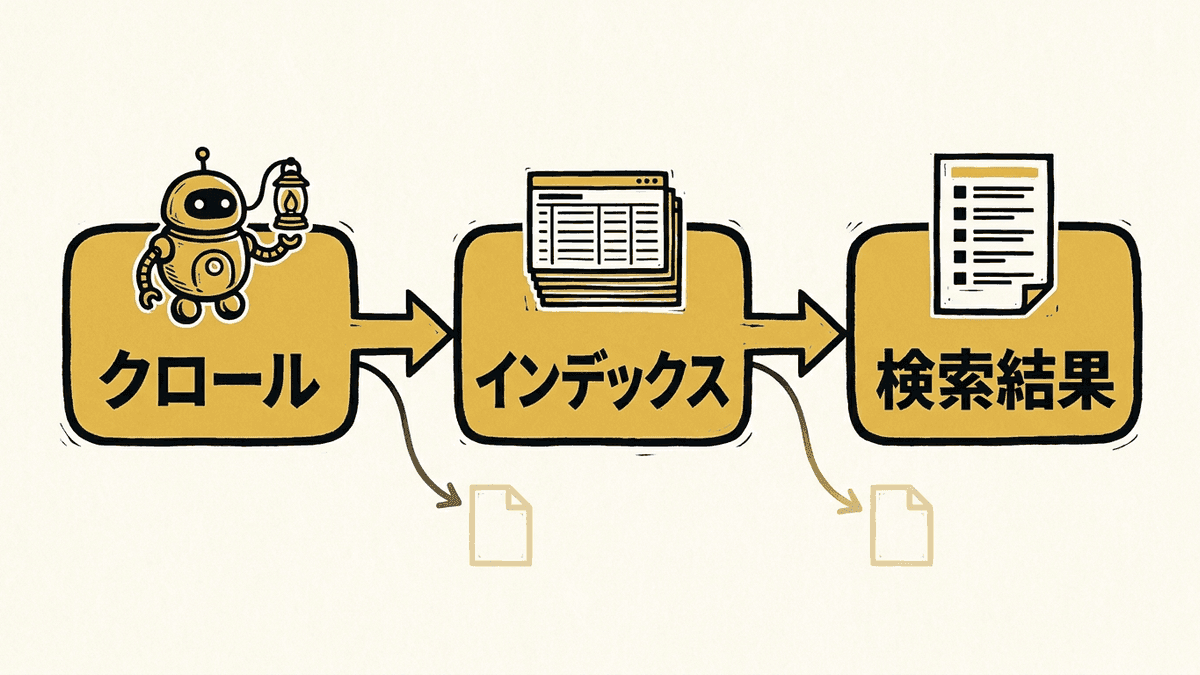
検索結果に出ないページを直すときは、クロールとインデックス登録のどちらで止まっているかで、直す場所が変わります。
※ 出典:Google 検索セントラル「Google の検索エンジンの仕組み、検索結果と掲載順位について」
クロールされたかを確かめる2つの方法
自社のページがクロールされたかを確かめる画面は、Search ConsoleのURL検査ツールとページのインデックス登録レポートの2つです。1ページずつ見るならURL検査ツール、サイト全体からクロールされていないページを探すならページのインデックス登録レポートを使います。
URL検査ツール
URL検査ツールでは、調べたいページのURLを入れると、Googleがそのページを前回いつクロールしたかと、クロールできたかが分かります。手順は次の3つです。
Search Consoleで自社のサイトを選び、画面上部の検索窓に、調べたいページのURLを「https://」から入力します。
検査結果の「ページのインデックス登録」の欄を開き、詳細を表示します。
「クロール」の欄に並ぶ項目のうち、次の表の3つを見ます。
3つの項目の意味は、次のとおりです。
項目 | 分かること |
|---|---|
前回のクロール | Googleがそのページを前回クロールした日時 |
クロールを許可? | 「いいえ」なら、robots.txtの指定でクロールを止めている |
ページの取得 | 「失敗」なら、サーバーエラーやログインが必要な設定などで、Googleがページを読めていない |
URL検査ツールに出るのは、前回クロールした時点の情報です。ページを直した後は、同じ画面の「公開URLをテスト」で、今のページをGoogleが読めるかを確かめます。
ページのインデックス登録レポート
ページのインデックス登録レポートでは、インデックスに登録されていないページが、登録されなかった理由ごとに一覧で表示されます。クロールに関わる表示は、次の2つです。
表示 | ページの状態 |
|---|---|
検出 - インデックス未登録 | GoogleがURLを見つけたが、まだクロールしていない |
クロール済み - インデックス未登録 | クロールはされたが、インデックスに登録されていない |
「検出 - インデックス未登録」の多くは、サイトへの負荷が大きくなりそうだとGoogleが判断し、クロールを先送りしている状態です。「クロール済み - インデックス未登録」のページはクロールの段階を通っているため、Googleはクロールをリクエストし直す必要はないとしています。
クロール済みなのに登録されないページの原因の切り分け方は、Googleにインデックスされない原因|状態別の切り分けと対処法にまとめました。
クロールしてもらうための3つの方法
Googleにページをクロールしてもらう方法は3つあり、記事を公開するたびに欠かさず行うのは内部リンクの設置です。Googleは、すでにクロールしたページの中のリンクと、サイト運営者が送るXMLサイトマップから新しいURLを見つけ、見つけたURLを読みに来ます。
内部リンクの設置
内部リンクは、同じサイトのほかのページから張るリンクです。Googleは、検索結果に出したいすべてのページに、同じサイトの別のページから少なくとも1つリンクを張ることを勧めています。
リンクは、href属性を持つaタグで書くのが前提です。ボタンを押したときにJavaScriptだけで移動する作りのリンクは、Googleがたどれないことがあります。
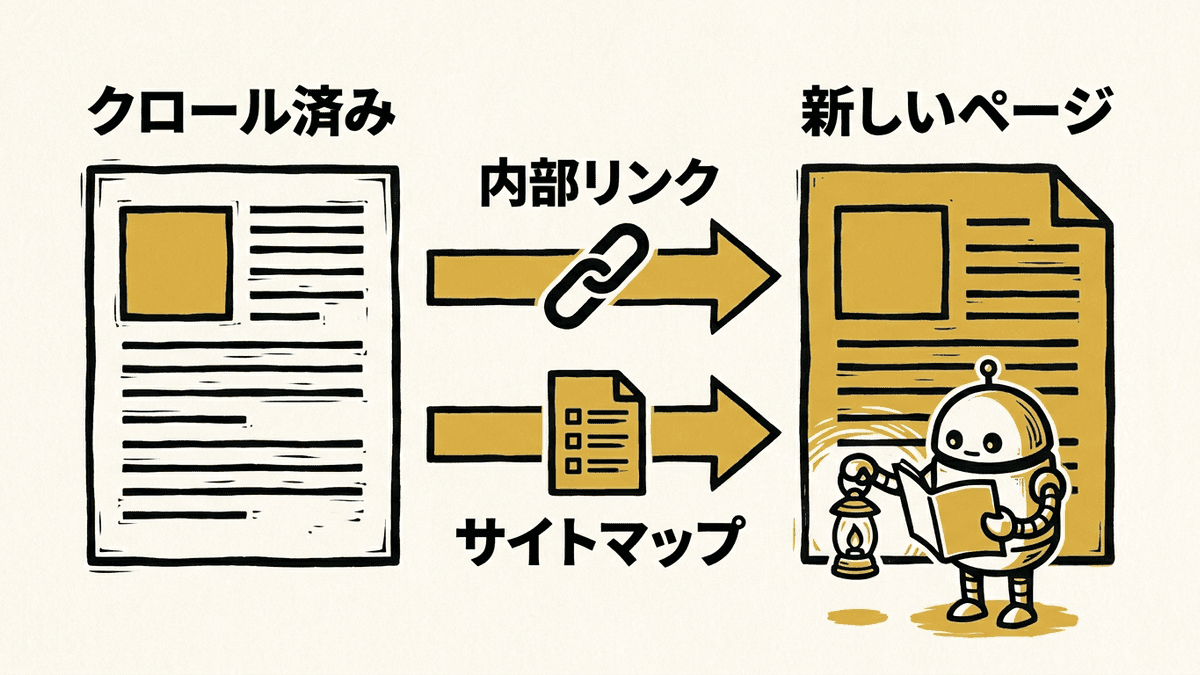
記事を公開したら、内容の近い既存の記事から新しい記事へリンクを張ります。カテゴリの一覧からしかリンクのない記事は、記事が増えるほど一覧の後ろのページに送られ、Googleに見つかりにくくなると見ています。
XMLサイトマップの送信
XMLサイトマップは、サイトのページのURLを一覧にしたファイルです。Search Consoleのサイトマップレポートから送ると、Googleが一覧のURLを見つけやすくなります。ただし、一覧に載せたURLがすべてクロールされるとは限りません。
Googleは、ページ数がおよそ500以下で、内部リンクから全ページにたどれるサイトなら、サイトマップが要らない場合があるとしています。WordPressなどのCMSはサイトマップを自動で作っていることが多いため、まず自社のサイトにあるかを確かめます。作り方と送り方は、XMLサイトマップとは?書き方と作り方、送信と確認の手順を解説で紹介しています。
URL検査ツールでのリクエスト
公開したばかりのページは、URL検査ツールの「インデックス登録をリクエスト」でクロールを頼めます。リクエストできるのは、Search Consoleでそのサイトのオーナーかフルユーザーの権限を持つ人です。新しく立ち上げたサイトなら、トップページの登録をリクエストするだけで、Googleがサイトのクロールを始めます。
1日に送れるリクエストの数には上限があり、同じURLを何度送ってもクロールは早まりません。書き直した公開済みのページはGoogleが自動でクロールし直すため、重要な変更が1週間以上反映されないときだけリクエストします。
新しい記事に、既存の記事からのリンクが張られていますか
記事を増やすたびに、どの記事から新しい記事へリンクを張るかを決めておかないと、カテゴリの一覧からしかリンクのない記事が増えていきます。サイトのURLと最近公開した記事のURLをお知らせいただければ、どの記事から新しい記事へ内部リンクを張るかを一緒に確かめます。
クロールの回数と検索順位の関係
クロールの回数が増えても、それだけで検索順位が上がるわけではありません。Googleは2017年の公式ブログで、クロールは検索結果に出るために必要だが、順位を決める要素ではないと説明しています。
クロールの量を気にする必要があるのは、大規模なサイトです。Googleが、クロールバジェット(1つのサイトのクロールに使える時間とリソースの上限)の資料で対象に挙げているのは、次の3種類のサイトです。
- 重複のないページが100万以上あり、週に1回ほど更新されるサイト
- 重複のないページが1万以上あり、毎日更新されるサイト
- Search ConsoleでURLの大部分が「検出 - インデックス未登録」になっているサイト
Googleは、ページ数は大まかな目安で、正確な境目ではないとしています。頻繁に更新するページが多くないサイトは、XMLサイトマップを最新に保ち、ページのインデックス登録レポートを定期的に見れば十分というのがGoogleの説明です。Search Consoleの「クロールの統計情報」レポートも、ページ数が1,000未満のサイトでは使う必要はないとGoogleは書いています。
数百本の記事を載せる企業のオウンドメディアなら、クロールの回数を増やす工夫より、新しい記事に内部リンクがあるかと、「クロール済み - インデックス未登録」の記事が増えていないかを見るほうが、検索結果に出る記事を増やせると見ています。
※ 出典:Google 検索セントラル「クロール バジェットを最適化する」
クロールを止める方法とnoindexの違い
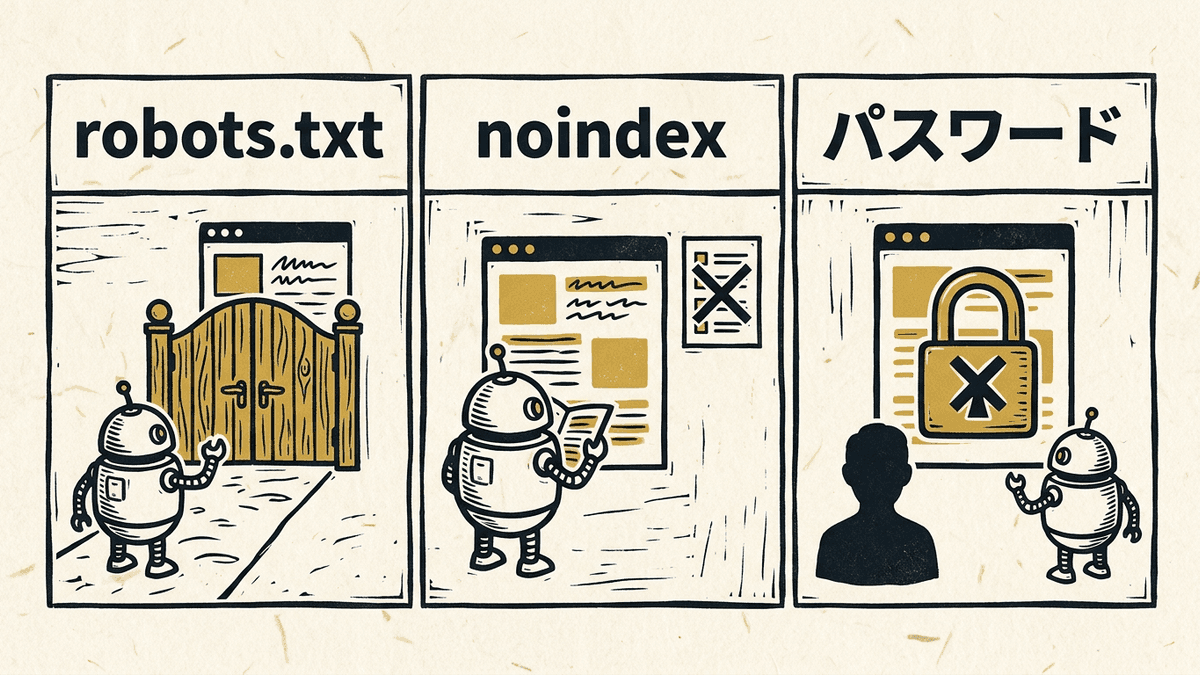
Googleのクロールを止めるにはrobots.txtを使いますが、検索結果からページを外したいときに使うのは、noindexかパスワードによる保護です。robots.txtは、サイトの直下に置くファイルで、クローラーにどのURLを読んでよいかを伝えます。
robots.txtで止めたページでも、ほかのページからリンクされていると、URLだけが説明文なしで検索結果に出ることがあります。
 Web担当者
社内向けのページを検索結果に出したくないので、robots.txtとnoindexを両方入れておけば確実ですよね。
 Writers-hub
編集部
両方入れると、noindexが効かなくなります。robots.txtでクロールを止めるとGoogleはページを読めず、ページの中に書いたnoindexにも気づけないためです。検索結果から外したいページはrobots.txtで止めずにnoindexだけを使い、社外に見せたくないページはパスワードで保護してください。
3つの方法で止まるものは、次のように違います。
方法 | 止まるもの | 向いているページ |
|---|---|---|
robots.txt | クロール | 並べ替えだけが違う一覧ページなど、クロールさせる必要のないページ |
noindex | インデックス登録 | 公開したまま、検索結果には出したくないページ |
パスワードによる保護 | クロールと閲覧 | 公開前のページなど、社外の人に見せないページ |
noindexの書き方は、noindexとは?書き方と設定方法・効かないときの原因を解説にまとめました。
クロールのよくある質問
クロールについてよくある質問は、次の3つです。
クロールとクローリングは違う?
クロールとクローリングは同じことを指します。英語の動詞のcrawlから来たのがクロール、名詞のcrawlingから来たのがクローリングです。Search Consoleの画面やGoogleの日本語の資料では、主に「クロール」が使われています。
クロールされるまで何日かかる?
Googleは、クロールに数日から数週間かかることがあると説明しています。進み具合は、URL検査ツールの「前回のクロール」の日時か、ページのインデックス登録レポートで確かめます。クロールされた後も、検索結果にすぐ出るとは限りません。
AIの会社のクローラーも来る?
ChatGPTを提供するOpenAIなど、AIの会社もクローラーを動かし、Webページをクロールしています。OpenAIは、ChatGPTの検索に使うOAI-SearchBotと、AIの学習に使うGPTBotを分けており、robots.txtでそれぞれを許可するか止めるかを決められます。AIのクローラーごとのrobots.txtの書き方は、Webクローラーとは?仕組みと種類、AIクローラーの扱い方まで解説にまとめました。
まとめ|クロールと検索結果への表示は別の段階
クロールは、Googleがページを読みに来る、検索結果に出るまでの最初の段階です。クロールされたことも、クロールの回数も、そのページが検索結果に出るかどうかや順位を決めるものではありません。
自社のページが検索結果に出ないときは、URL検査ツールとページのインデックス登録レポートで、まだクロールされていないのか、クロールの後で止まっているのかを先に確かめます。クロールされていないページには内部リンクを張り、検索結果から外したいページにはnoindexを使います。
私たち合同会社Writers-hubは、企業のオウンドメディアの記事制作と、内部リンクなどサイトの作りの見直しを支援しています。
検索結果に出ない記事が、どの段階で止まっているか分かっていますか
ページのインデックス登録レポートの画面や、検索結果に出ない記事のURLをお送りいただければ、クロールとインデックス登録のどちらで止まっているかを確かめ、直す順番を一緒に決めます。記事の制作と、サイトの作りの見直しのどちらから手を付けるか決めていない段階でも、ご相談いただけます。