「クローリングとスクレイピングは、どちらもWebから自動でデータを集めることだから、同じ意味だろう」。どちらもWebから自動でデータを集める話の中で使われるため、言い方が違うだけと受け取られがちです。ところが、クローリングが指すのは、リンクをたどってページを集めて回る工程だけです。集めたページから価格などの項目を抜き出す作業はスクレイピングと呼ばれ、クローリングとは別の工程にあたります。
本記事では、クローリングの意味から、スクレイピングとの違い、自社サイトと他社サイトをクローリングするときに確かめることまで、SEO記事の制作を手がける制作会社の視点で順を追ってお伝えします。
- クローリングはページを集める工程で、項目を抜き出すスクレイピングとは役割が分かれる
- Googleにクローリングされても、インデックスに登録されなければ検索結果には出ない
- 自社サイトをSEOツールでクローリングすると、リンク切れやリンクからたどれないページが見つかる
- 他社サイトをクローリングするときは、利用規約とrobots.txtを確かめ、間隔を空けて取得する
クローリングの意味と流れ
クローリングとは、プログラムがWebページのリンクをたどりながら、ページを自動で取得して回ることです。クローリングを行うプログラムはクローラーといい、ボットやスパイダーとも呼ばれます。検索エンジンが検索結果に載せるページを集めるときのほか、企業が他社サイトの価格や求人の情報を集めるときや、自社サイトを点検するときにも使われます。
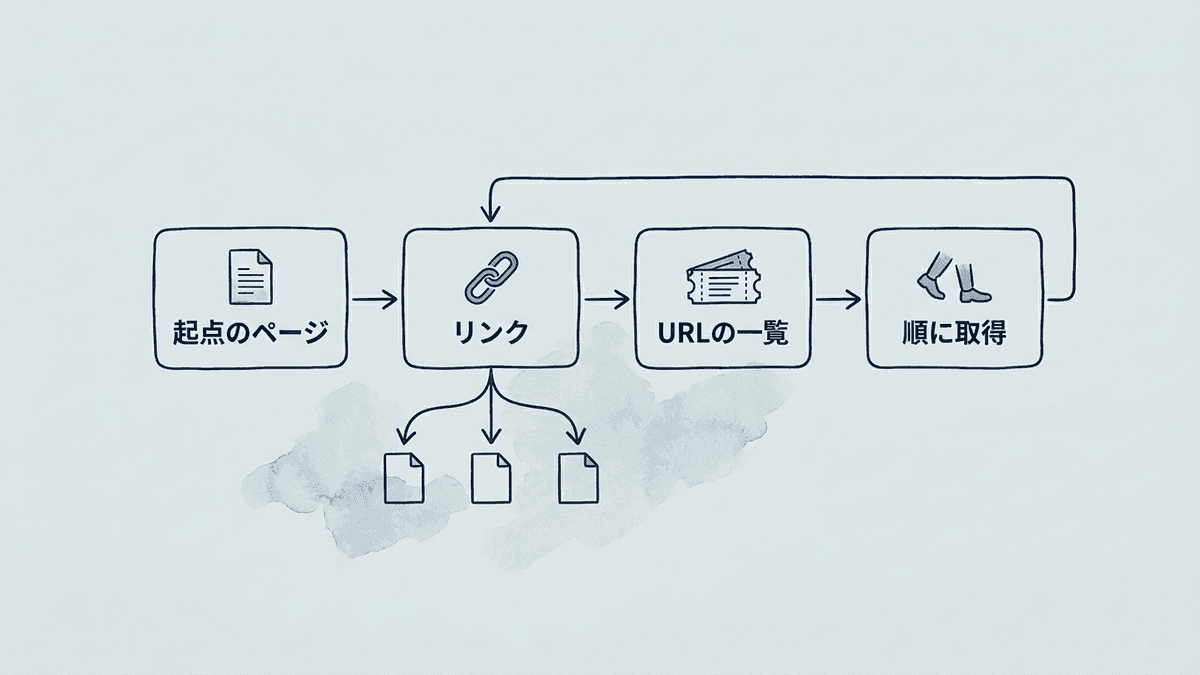
クローラーが行うのは、次の4つの手順の繰り返しです。
巡回を始めるURL(起点のURL)のページをダウンロードします。ルールを守るクローラーは、取得の前にサイトのrobots.txtを読み、拒否されたURLを取得しません。
取得したページのHTMLから、ほかのページへのリンクのURLを取り出します。
取り出したURLのうち、まだ取得していないものを、次に取得するURLの一覧に加えます。
一覧のURLを1つずつ取得し、取得したページからも同じようにリンクを取り出します。一覧が空になるか、決めたページ数に達したら終わります。
クローラーが新しいURLを知る主な手段は、取得済みのページにあるリンクと、サイト運営者が渡すURLの一覧(XMLサイトマップ)です。どこからもリンクされず、サイトマップにも無いページは見つかりにくくなります。
スクレイピングやインデックスとの違い
クローリングがページを集める工程なのに対し、スクレイピングとインデックス登録は、集めたページを使う側の工程です。
工程 | やること | できあがるもの |
|---|---|---|
クローリング | リンクをたどってページを集める | 取得したページとURLの一覧 |
スクレイピング | 集めたページから価格や日付などの項目を抜き出す | 項目を並べた表のデータ |
インデックス登録 | 検索エンジンがページの内容を解析し、検索用のデータベースに保存する | 検索エンジンのインデックス |
たとえば競合の価格を調べるなら、商品一覧のページからリンクをたどって各商品のページを集めるまでがクローリングです。各ページから価格の欄だけを取り出して表にする作業が、スクレイピングにあたります。
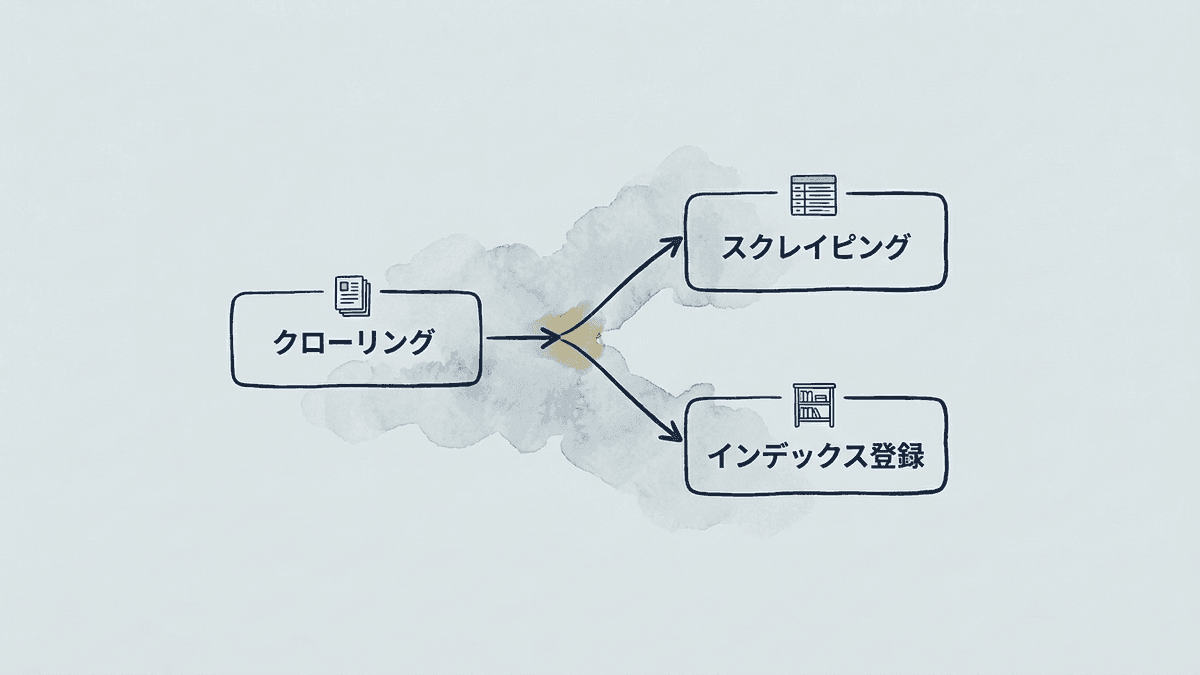
検索結果に出ないページなら、クローリングされていないのか、クローリングの後にインデックスへの登録が見送られたのかで、直す場所が変わります。
Googleのクローリングと検索結果の関係
Googleの検索結果に出るのは、原則としてGooglebotにクローリングされたうえで、インデックスに登録されたページです。Googleは、クローリングしたページがすべてインデックスに登録されるわけではないと説明しています。
Search Consoleで見るクローリング状況
自社のページがどこで止まっているかは、Search Consoleのページ インデックス登録レポートで確かめられます。クローリングに関わる主な表示は、次の3つです。
Search Consoleの表示 | ページの状態 |
|---|---|
検出 - インデックス未登録 | URLは見つかったが、まだクローリングされていない |
クロール済み - インデックス未登録 | クローリングはされたが、インデックスに登録されていない |
URL が robots.txt によってブロックされています | robots.txtの指定で、クローリングを拒否している |
「検出 - インデックス未登録」の多くは、GoogleがURLを見つけたものの、サイトへの負荷を避けるためにクローリングを先送りしている状態です。「クロール済み - インデックス未登録」はクローリングの問題ではありません。Googleはクロールをリクエストし直す必要はないとしています。登録されない原因の切り分け方は、Googleにインデックスされない原因|状態別の切り分けと対処法にまとめました。
※ 出典:Search Console ヘルプ「ページ インデックス登録レポート」
クローリングを早める方法と止める方法
新しいページのクローリングを早める方法は、XMLサイトマップの送信と、URL検査ツールでのインデックス登録のリクエストの2つです。同じURLのリクエストを何度送っても、早くクローリングされることはありません。リクエストの手順は、Googleクローラーとは?巡回申請の方法と来ないときの原因を解説で紹介しています。
 Web担当者
公開前のページは、robots.txtでクローリングを止めておけば、検索結果に出ないですよね。
 Writers-hub
編集部
robots.txtで、Googlebotのクローリングは止められます。ただ、ほかのサイトからリンクされていると、ページの中身を読まないままURLだけが検索結果に出ることがあります。公開前のページはパスワードで保護し、公開後に検索結果から外したいページにはnoindexを使います。noindexはページを読まれないと効かないため、同じページをrobots.txtで止めないようにしてください。
クロールバジェット(Googleが1つのサイトのクローリングにかけられる時間とリソースの上限)を気にする必要があるのは、大規模なサイトです。Googleは、重複のないページが1万以上あって毎日更新されるサイトなどを対象に挙げ、頻繁に更新されるページが多くないサイトは、サイトマップを最新に保ち、ページ インデックス登録レポートを定期的に確かめれば十分としています。
クロール済みなのに登録されないページが増えていませんか
クローリングされているのに登録されないページは、ほかのページとの重複か、内容の不足かで直し方が変わります。Writers-hubのSEO・AI検索対策では、Search Consoleのレポートとサイトの構造を確かめ、直すページの順番から一緒に決めます。
自社サイトを自分でクローリングして分かること
自社サイトをSEOツールでクローリングすると、Googlebotと同じようにリンクをたどったとき、どのページにたどり着けて、どのページに問題があるかが分かります。Search Consoleに出るのはGoogleがクローリングした後の結果ですが、自分でクローリングすれば、直した箇所をその場で確かめ直せます。
SEOツールのクローリングで見つかる主な問題は、次の3つです。
- リンク切れ:リンク先が404などのエラーを返すページ
- noindexの付け間違い:検索結果に出したいのに、noindexが指定されたページ
- タイトルの抜けや重複:titleタグが空か、ほかのページと同じページ
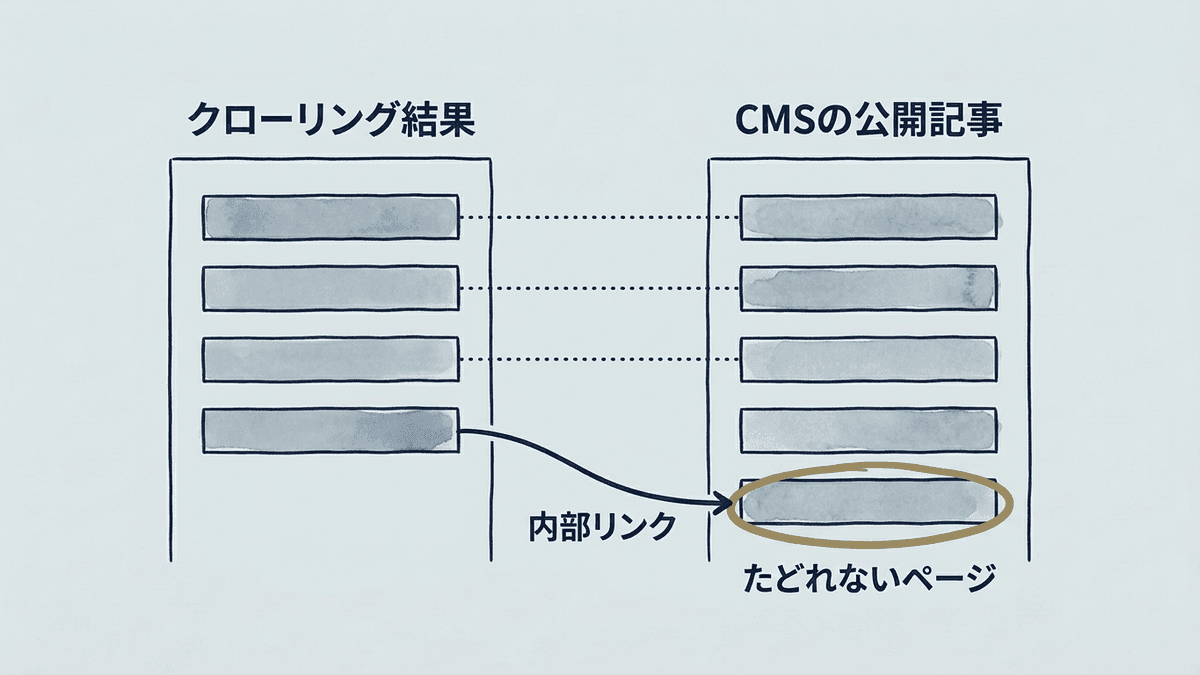
とりわけ見落とされがちなのが、どのページからもリンクされず、リンクからたどれないページです。リンクをたどるクローリングでは見つからないため、クローリングの結果から書き出したURLの一覧を、CMSの公開記事の一覧と見比べて探します。クローリングの結果に無いページには、内部リンクを張ります。
Screaming FrogのSEO Spiderは、無料版でも500URLまでクローリングできます。ただし無料版はJavaScriptを実行しないため、JavaScriptで後から表示するリンクはたどれません。
GoogleのクローリングはSearch Consoleの「クロールの統計情報」レポートでも見られますが、Googleは、ページ数が1,000未満のサイトではクロールの統計情報レポートを使う必要はないとしています。数百ページのサイトなら、ページ インデックス登録レポートと自分でのクローリングで、点検に要る情報はそろうと見ています。
他社サイトの情報をクローリングで集める手順
他社サイトの情報をクローリングで集めるときは、相手サイトのルールを確かめてから、間隔を空けて取得します。手順は次の5つです。
起点のURL、たどるリンクの範囲、取り出す項目と、取得するページ数の上限を決めます。
相手のサイトがAPIやデータのダウンロードを用意していれば、クローリングせずにAPIや配布データを使います。
利用規約で自動での取得が禁じられていないかと、ドメインの直下に置かれたrobots.txtで集めたいURLが拒否されていないかを見ます。
1回の取得ごとに数秒の間隔を空け、同時に複数のリクエストを送りません。Googleも、Googlebotは平均して数秒に1回を超える頻度ではサイトにアクセスしないと説明しています。
429(リクエストが多すぎる)や500番台のエラーが返ってきたら取得を止め、間隔を広げてからやり直します。
プログラムを書かずに集めるなら、取り出す項目を画面で選ぶノーコードのツールか、収集代行のサービスを使います。どちらを選ぶかは、相手サイトの作りが変わって取得が止まったときに、自社で設定を直せるかで決まります。
Pythonで書くときの基本形
Pythonで書くクローラーは、起点のURLと同じドメインのページだけを、最大50ページまで3秒おきに取得し、各ページのタイトルを表示する次のコードで足ります。
import time
from urllib.parse import urljoin, urlparse
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

START_URL = "https://example.com/"  # 起点のURL
USER_AGENT = "MyCrawler/1.0 (+https://example.com/contact)"  # 名乗る名前と連絡先
INTERVAL = 3  # 1回の取得ごとに空ける秒数
MAX_PAGES = 50  # 取得するページ数の上限

robots = RobotFileParser(urljoin(START_URL, "/robots.txt"))
robots.read()
host = urlparse(START_URL).netloc
queue, seen, fetched = [START_URL], {START_URL}, 0

while queue and fetched < MAX_PAGES:
    url = queue.pop(0)
    if not robots.can_fetch(USER_AGENT, url):
        continue  # robots.txtで拒否されたURLは取得しない
    res = requests.get(url, headers={"User-Agent": USER_AGENT}, timeout=10)
    fetched += 1
    time.sleep(INTERVAL)
    if res.status_code == 429 or res.status_code >= 500:
        break  # 相手のサーバーが混み合っている合図が出たら止める
    if "text/html" not in res.headers.get("Content-Type", ""):
        continue
    soup = BeautifulSoup(res.content, "html.parser")
    print(url, soup.title.string if soup.title else "")
    for a in soup.find_all("a", href=True):
        link = urljoin(url, a["href"]).split("#")[0]
        if urlparse(link).netloc == host and link not in seen:
            seen.add(link)
            queue.append(link)
動かす前に、requestsとbeautifulsoup4の2つのライブラリを入れておきます。
生成AIに書かせたクローラーのコードも、動かす前に、robots.txtで拒否されたURLを飛ばす処理、1回の取得ごとに間隔を空ける処理、429や500番台のエラーで止める処理が入っているかを確かめます。
他社サイトの確認と転記に、毎週の作業時間を取られていませんか
クローリングで情報を集める仕組みは、相手サイトの規約の確認と、サイトの作りが変わったときの直し方まで決めておかないと、途中で止まります。Writers-hubの業務効率化・自動化では、集めたい情報と対象のサイトを伺い、規約の範囲で自動化する方法を一緒に決めます。
クローリングが違法になるケース
クローリングは、公開されているページを集めるだけなら、それ自体で違法になるわけではありません。問題になるのは、集め方か、集めたデータの使い方が、主に次の4つに当たるときです。
- 規約で禁じられた自動取得:規約に同意して使うサービスなら、契約違反の責任を問われるおそれがある
- 障害を起こすほどのアクセス:業務妨害の疑いをかけられるおそれがある
- 集めた文章や画像の転載:著作権の侵害にあたるおそれがある
- 目的を示さない個人情報の利用:個人情報保護法が求める、利用目的の通知か公表の義務に反する
相手のサーバーがどこまで耐えられるかは集める側から分からないため、エラーが返ってきたら止める処理が欠かせません。
集めた文章や画像を分析に使うだけなら、著作権法30条の4により、原則として著作権者の許諾は要りません。ただし、著作権者の利益を不当に害する場合は対象外で、集めた文章や画像を人に読ませるために載せる使い方も、同じ条文が認める利用には入りません。
※ 出典:e-Gov法令検索「著作権法」
Googleの検索結果をクローリングで集めたいときの規約と代わりの方法は、Google検索結果のスクレイピングは禁止?規約と代わりの取得方法にまとめました。
クローリングのよくある質問
クローリングについてよくある質問は、次の3つです。
クロールとクローリングは、どちらもプログラムがリンクをたどってページを取得して回ることを指します。英語の動詞のcrawlをそのまま使うのが「クロール」、名詞のcrawlingから来たのが「クローリング」で、Googleの説明やSearch Consoleの表示では「クロール」が使われています。
Googleは、クロールに数日から数週間かかることがあると説明しています。クロールされても検索結果にすぐ出るとは限らず、出ないこともあります。進み具合は、URL検査ツールかページ インデックス登録レポートで確かめます。
AIのクローリングは、robots.txtでAI企業のクローラーを名前で指定すれば断れます。OpenAIは、ChatGPTの検索に使うOAI-SearchBotと学習に使うGPTBotを分けており、GPTBotだけを拒否すれば、学習への利用を断ったまま検索回答に出る道を残せます。Googleでは「Google-Extended」を拒否するとGeminiの学習などへの利用を断れ、Google検索への登録や順位には影響しません。
クローラーごとのrobots.txtの書き方は、Webクローラーとは?仕組みと種類、AIクローラーの扱い方まで解説にまとめました。
まとめ|クローリングは集める工程だけを指す
クローリングは、リンクをたどってページを集める工程だけを指します。項目を抜き出すスクレイピングや、検索用に保存するインデックス登録と分けて考えると、検索結果に出ない原因やデータ収集で守るルールを、どの工程で確かめればよいかが分かります。
自社サイトでは、Search Consoleでクローリングとインデックス登録のどちらで止まっているかを確かめ、リンクからたどれないページは自分でクローリングして見つけます。他社サイトから情報を集めるときは、利用規約とrobots.txtを確かめてから、間隔を空けて取得します。
私たち合同会社Writers-hubは、SEO記事の制作から、検索エンジンとAI検索に読まれるサイトの点検、情報収集などの業務の自動化までを支援しています。
Search Consoleの表示とクロールの結果、どこから直すか迷っていませんか
ページ インデックス登録レポートの画面や、SEOツールで書き出したURLの一覧をお送りいただければ、どのページから直すかを一緒に確かめます。検索対策と情報収集の自動化のどちらから手を付けるか決めていない段階でも、ご相談いただけます。